跳转至

08/2024

字典树 做题记录

P4551

P4551

钦定根为 \(root\),我们首先考虑从 \(root\) 开始 \(dfs\) 处理出每个节点 \(i\) 到其的距离 \(dis[i]\);由于两节点的 \(LCA\) 部分对最终的异或答案不产生影响,有一个很显然的想法是枚举每对节点取最大值,但 \(O(n^2)\) 无法接受,需要效率更优的算法

已知节点 \(i\),不用枚举,如何算出其他节点到 \(i\) 的异或路径长度最大值?可以按位考虑 贪心;从高到低枚举每一位,我们希望新节点的当前位与 \(dis[i]\) 的当前位尽量不同;但是可能无法保证新节点的当前位总不同,即需要 验证不同的一位是否存在,这可以使用 \(01trie\) 维护

具体的,我们将每一个 \(dis[i]\) 插入字典树,枚举每个距离 \(dis[i]\),维护当前字典树上的节点 \(node\),使得 \(node\) 能往与当前位不同的节点走就往不同的节点走即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
#define ll long long
const int MAXN = 1e5+5, MAXL = 4e6+5;

int n, cnt;
ll ans;
ll dis[MAXN];

struct Edge{
    int to;
    ll weig;
};
vector <Edge> G[MAXN];

struct Node{
    int nex[2];
    bool exist;
}trie[MAXL];

void insert(ll x){
    int node = 0;
    for (int i=31; i>=0; i--){
        int c = ((x>>i)&1);
        if (!trie[node].nex[c]) cnt++, trie[node].nex[c]=cnt;
        node = trie[node].nex[c];
    }
    trie[node].exist = true;
}

void getans(ll x){
    int node = 0;
    ll res = 0;
    for (int i=31; i>=0; i--){
        int c = ((x>>i)&1);
        if (trie[node].nex[(c^1)]) node=trie[node].nex[(c^1)], res = (res|(1<<i));
        else node = trie[node].nex[c];
    }
    ans = max(ans, res);
}

void dfs(int node, int fa, ll rdis){
    dis[node] = rdis;
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i].to == fa) continue;
        dfs(G[node][i].to, node, (rdis^G[node][i].weig));
    }   
}

void show(int node, string s){
    if (trie[node].exist) cout << s << endl;
    if (trie[node].nex[0]) show(trie[node].nex[0], s+"0");
    if (trie[node].nex[1]) show(trie[node].nex[1], s+"1");
}

int main(){
    scanf("%d", &n);
    for (int i=1; i<=n-1; i++){
        int node1, node2;
        ll weig;
        scanf("%d%d%lld", &node1, &node2, &weig);
        G[node1].push_back({node2, weig});
        G[node2].push_back({node1, weig});
    }

    dfs(1, 1, 0);

    for (int i=1; i<=n; i++){
        insert(dis[i]);
    }
    // show(0, "");
    for (int i=1; i<=n; i++){
        getans(dis[i]);
    }

    printf("%lld", ans);
    return 0;
}

P3294

P3294

先总结题意,设当前位置为 \(x\),总共有 \(n\) 个单词 1. 如果当前单词存在一个后缀,其位置在 \(x\) 后,花费加 \(n^2\) 2. 如果当前单词没有后缀,花费加 \(x\) 3. 如果当前单词所有后缀的位置都在 \(x\) 前,设这些位置中的最大值为 \(y\),花费加 \(x-y\)

我们发现,第 \(1\) 个情况的花费开销实在太大,远远高过后两种情况,因此我们要避免,即 使得单词的所有后缀都在填在其前面;对于另外两种情况,实质上情况 \(2\) 是情况 \(3\) 在 \(y=0\) 时的特殊情况,因此只需要考虑情况 \(3\) 即可

显然我们需要处理单词间的后缀关系,很自然的想法就是 将每个单词反转插入字典树;字典树中非实际存在的节点没有用,因此我们进一步建出其 重构树,实质上即每个节点的最长后缀向该节点连边形成的树;我们考虑在其上进行操作

其实感性理解上,我们发现将树上的每条链连在一起的这种排法看起来比较优秀,因为再把任何一个其他链上的节点插进去会增加链后所有节点的花费;这实际上是 \(dfs\) 序;

尝试证明这一结论;发现所有的花费中都含 \(x\),因此只需考虑 \(-y\),即我们想让 \(\sum-y\) 最小,即 \(\sum y\) 最大;对于位置 \(x\),其相应的 \(y\) 显然满足 \(y \le x\),我们想让 \(y\) 尽量大,那么最好就与 \(x\) *相邻* (或者就是 \(x\));如何让其相邻?实际上就是把链上的节点连在一起,中间没有其他链的节点;即得证

现在我们可以把每条链看做一个整体;还没完,链的长度显然也会对答案产生影响;对于节点 \(i\) 每个子树的根节点 \(j\),其价值开销就是在 \(j\) 前 \(i\) 所有儿子的子树大小和,那么肯定 从小到大排序 最优;其实很容易理解,这就相当于排队打水计算每个人等待时间的和,肯定让打水时间少的人站在前面更优

实现上,对于重构树,我们使用并查集记录节点 \(x\) 的 \(fa[x]\) 表示在 \(x\) 上方存在且最近的节点 (如果上方没有也可以是 \(x\) 自身),维护并查集,在搜到存在的节点 \(i\) 时使 \(last[i]\) 与 \(i\) 连边即可

别忘了排序,统计答案时直接按照 \(dfs\) 序即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
#define ll long long
const int MAXL = 5e5+5, MAXN = 1e5+5;

int n, cnt, recnt;
int fa[MAXL];
ll ans;
string s;

struct Node{
    int child[26];
    bool exist;
    Node(){memset(child, 0, sizeof(child)); exist=false;}
}trie[MAXL];

struct ReNode{
    vector <int> child;
    int siz;
    ReNode(){child.clear(); siz=0;}
}retrie[MAXL];

void insert(string s){
    int node = 1;
    for (int i=s.size()-1; i>=0; i--){
        int u = s[i]-'a';
        if (!trie[node].child[u]) cnt++, trie[node].child[u] = cnt;
        node = trie[node].child[u];
    }
    if (!trie[node].exist) trie[node].exist = true;
    return;
}

void dfs(int node){
    if (trie[node].exist == true && node>1){
        retrie[fa[node]].child.push_back(node);
        fa[node] = node;
    }
    for (int i=0; i<26; i++){
        if (trie[node].child[i]){
            fa[trie[node].child[i]] = fa[node]; 
            dfs(trie[node].child[i]);   
        }
    }
}

void dfssiz(int node){
    retrie[node].siz = 1;
    for (int i=0; i<retrie[node].child.size(); i++){
        dfssiz(retrie[node].child[i]);
        retrie[node].siz += retrie[retrie[node].child[i]].siz;
    }
}

bool cmp(int a, int b){
    return retrie[a].siz < retrie[b].siz;
}

void dfssort(int node){
    sort(retrie[node].child.begin(), retrie[node].child.end(), cmp);
    for (int i=0; i<retrie[node].child.size(); i++){
        dfssort(retrie[node].child[i]); 
    }    
}

void get(int node){
    int tmp = recnt;
    recnt++;
    for (int i=0; i<retrie[node].child.size(); i++){
        ans += recnt-tmp;
        get(retrie[node].child[i]);
    }   
}

int main(){
    ios::sync_with_stdio(false);
    cin.tie(0), cout.tie(0);

    cnt = 1;
    cin >> n;
    for (int i=1; i<=n; i++){
        cin >> s;
        insert(s);
    }
    trie[1].exist = true;
    fa[1] = 1;
    dfs(1);
    dfssiz(1);
    dfssort(1);
    get(1);

    cout << ans;
    return 0;
}

P2292

P2292

字典树什么东西,直接上自动机

有一个显然的 \(dp\),记 \(dp[i]\) 表示文本串前 \(i\) 位是否能被理解 (可行性 \(dp\)),转移即对于每个 \(i\),枚举 \(j(1 \le j \le i)\),若 \(s[j]s[j+1]...s[i]\) 是字典中的一个单词且 \(dp[j-1]\) 为真,\(dp[i]\) 即为真

初值即为 \(dp[0] = true\)

对于文本串的前缀,我们发现需要处理出其所有在字典中的后缀进行转移,这很显然就是 \(AC\) 自动机,一直跳 \(fail\) 即可;直接做会超时,考虑进行玄学优化

记录字典中单词的最大长度 \(maxl\),对于文本串当前位 \(i\),维护 \(i\) 之前可以被理解的最大位置 \(maxpl\),显然当 \(maxl+maxpl < i\) 时可以直接返回假;另外,当 \(dp[i]\) 已经为真时就没必要继续跳了,直接返回即可;这样就水过了此题

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXL = 2e6+5, MAXT = 2e4+5;

int n, m, cnt, maxl, maxpl;
bool dp[MAXL];
string s;

struct Node{
    int child[26];
    int fail;
    int len;
    int exist;

    Node(){memset(child, 0, sizeof(child)); fail = len = exist = 0;}
}trie[MAXT];

void insert(string s){
    int node = 1;
    for (int i=0; i<s.size(); i++){
        int u = s[i]-'a';
        if (!trie[node].child[u]) cnt++, trie[node].child[u] = cnt;
        node = trie[node].child[u];
        trie[node].len = i+1;
    }
    if (!trie[node].exist) trie[node].exist=1;
    maxl = max(maxl, trie[node].len);
    return;
}

queue <int> q;

void build(){
    for (int i=0; i<26; i++) trie[0].child[i] = 1;
    trie[1].fail = 0;
    q.push(1);

    while (!q.empty()){
        int node = q.front();
        q.pop();
        int fail = trie[node].fail;

        for (int i=0; i<26; i++){
            int v = trie[node].child[i];
            if (v){
                trie[v].fail = trie[fail].child[i];
                q.push(v);
            }
            else{
                trie[node].child[i] = trie[fail].child[i];
            }
        }   
    }
}

void query(string s){
    int node = 1;
    for (int i=0; i<s.size(); i++){
        int u = s[i]-'a';
        node = trie[node].child[u];
        for (int j=node; j>1; j=trie[j].fail){
            if (trie[j].exist == 1){
                dp[i+1] = (dp[i+1] | dp[i+1-trie[j].len]);
                if (dp[i+1] == true){maxpl = max(maxpl, i+1); break;}
                if (maxpl+maxl < i+1) break;                
            }
        }
    }       
}

int main(){
    ios::sync_with_stdio(false);
    cin.tie(0), cout.tie(0);

    cnt = 1;
    cin >> n >> m;
    for (int i=1; i<=n; i++){
        cin >> s;
        insert(s);
    }
    build();
    for (int i=1; i<=m; i++){
        memset(dp, false, sizeof(dp));
        dp[0] = true;
        maxpl = 0;
        cin >> s;
        query(s);
        cout << maxpl << endl;
    }
    return 0;
}

P2922

P2922

我们在字典树中插入每个 \(b_i\);设当前处理的文本为 \(c\),维护字典树上每个节点 \(node\) 被包含的次数 \(cnt1\) (注意当单词在该节点结束时也统计) 与在 \(node\) 上 结束的单词数 \(cnt2\)

这样,设 \(c\) 在字典树上的终止节点为 \(node\),对于 \(c\) 包含 \(b_i\) 的情况,我们只需要统计从根到 \(node\) 上的 \(\sum cnt2\);对于 \(b_i\) 包含 \(c\) 的情况,我们只需要统计 \(node\) 上的 \(cnt1\);需要注意,由于我们在单词的终止节点同时增加了 \(cnt1\) 与 \(cnt2\) 的贡献,因此这样我们会 多算一遍 \(node\) 上的 \(cnt2\)

最终答案即为 \(\sum cnt2+cnt1_{node}-cnt2_{node}\)

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXL = 5e5+5;

int N, M, num, nc, cnt, res;
string tmp;

struct Node{
    int nex[2];
    bool exist;
    int cnt1, cnt2;
    Node(){nex[0]=nex[1]=0;exist=false;cnt1=cnt2=0;}
}trie[MAXL];

void insert(string s){
    int node = 0;
    for (int i=0; i<s.size(); i++){
        int c = s[i]-'0';
        if (!trie[node].nex[c]) cnt++,trie[node].nex[c]=cnt;
        node = trie[node].nex[c];
        trie[node].cnt1++;
    }
    trie[node].cnt2++;
}

int query(string s){
    int node = 0, res = 0;
    for (int i=0; i<s.size(); i++){
        int c = s[i]-'0';
        if (!trie[node].nex[c]) return res;
        node = trie[node].nex[c];
        res += trie[node].cnt2;
    }
    res += (trie[node].cnt1-trie[node].cnt2);
    return res;
}

int main(){
    scanf("%d%d", &N, &M);
    for (int i=1; i<=N; i++){
        scanf("%d", &num);
        tmp = "";
        for (int j=1; j<=num; j++){
            scanf("%d", &nc);
            tmp += (nc+'0');
        }
        insert(tmp);
    }
    for (int i=1; i<=M; i++){
        scanf("%d", &num);
        tmp = "";
        for (int j=1; j<=num; j++){
            scanf("%d", &nc);
            tmp += (nc+'0');
        }
        printf("%d\n", query(tmp));
    }
    return 0;
}

2024.7.24 模拟赛记录

T1 - 采果子

采果子

Sol

注意到图是完全图,且我们只能从果子数低向果子数高走,因此先考虑将其按照 \(a[i]\) 从小到大排序,这样之后再进行操作可以确保无后效性

考虑 \(dp\);题目问什么就设什么,尝试设 \(dp[i][j]\) 表示走到第 \(i\) 棵树 还剩 \(j\) 小时,同时 摘走第 \(i\) 棵树的果子 能获得的最大价值;其实转移比较类似 \(01\) 背包,考虑枚举当前第 \(i\) 棵树与容量 \(j\),再枚举前面的某一棵树 \(k\),转移即为从 \(k\) 走到 \(i\);因此,转移方程为 \(dp[i][j]=dp[k][j-dis[k][i]-c[i]]+s[i]\),其中 \(c[i]\) 表示摘第 \(i\) 棵树上果子的时间,\(s[i]\) 表示摘第 \(i\) 棵树上果子的价值

注意,因为我们可以从任何一棵树开始,比较方便的一种处理方法是建立一个超级原点 \(0\),自身的所有信息都是 \(0\),再向所有树都连一条权值为 \(0\) 的边

对于初值,直接赋 \(0\) 即可,因为浪费了一些时间的初始情况一定比不浪费是更劣的,不会对答案造成影响;对于答案,我们枚举每个状态,取最大值即可

时间复杂度 \(O(n^2m)\)

C++
#include<bits/stdc++.h>
using namespace std;
#define ll long long
const int MAXN = 105, MAXM = 1005, INF = 1e9;

int n, m;
ll ans;
ll d[MAXN][MAXN];
ll dp[MAXN][MAXM];

struct Tree{
    ll a, s, c, id;
}tree[MAXN];

bool cmp(Tree t1, Tree t2){
    return t1.a < t2.a;
}

int main(){
    scanf("%d%d", &n, &m);

    for (int i=1; i<=n; i++){
        scanf("%lld%lld%lld", &tree[i].a, &tree[i].s, &tree[i].c);
        tree[i].id = i;
    }
    for (int i=1; i<=n; i++){
        d[0][i] = 0;
        for (int j=1; j<=n; j++){
            scanf("%lld", &d[i][j]);
        }       
    }
    tree[0].a = tree[0].s = tree[0].c = tree[0].id = 0;
    sort(tree, tree+n+1, cmp);

    for (int i=0; i<=n; i++){
        for (ll j=m; j>=0; j--){
            for (int k=0; k<i; k++){
                if (j >= d[tree[k].id][tree[i].id]+tree[i].c && tree[k].a<tree[i].a){
                    dp[i][j] = max(dp[i][j], dp[k][j-d[tree[k].id][tree[i].id]-tree[i].c]+tree[i].s);
                }   
            }
        }
    }
    for (int i=1; i<=n; i++){
        for (int j=0; j<=m; j++){
            // cout << i << " " << j << " " << dp[i][j] <<endl;
            ans = max(dp[i][j], ans);
        }
    }

    printf("%lld", ans);
    return 0;
}

Record

别被图论限制了思路啊,这个 \(dp\) 还是比较明显的;现在 \(dp\) 的水平真的太差了,得多练。

T2 - 非常计划

非常计划

Sol

玩文字游戏是比较难评的……

最短路计数板子,注意 有重边就取最小值,这是由于所有边完全重合只算一次,因此有多条重边对结果没有影响;因为要取最小值,用邻接矩阵会比较方便,\(O(n^2)\) 是可以接受的

时间复杂度 \(O(n^2)\)

C++
#include<bits/stdc++.h>
using namespace std;
#define ll long long
const int MAXN = 2005, INF = 1e9;

int N, M;

struct Edge{
    int to;
    int weig;
};

int G[MAXN][MAXN];
int dis[MAXN], vis[MAXN];
ll cnt[MAXN];

void dijkstra(int start){
    memset(dis, 0x7f, sizeof(dis));
    dis[start] = 0;
    cnt[start] = 1;

    for (int i=1; i<=N; i++){
        int recent = 0, recentmin = INF;
        for (int j=1; j<=N; j++){
            if (vis[j] == false && dis[j] < recentmin){
                recent = j;
                recentmin = dis[j];
            }   
        }
        vis[recent] = true;
        for (int j=1; j<=N; j++){
            if (G[recent][j] != INF){
                if (dis[j] >= dis[recent]+G[recent][j]){
                    if (dis[j] == dis[recent]+G[recent][j]){
                        cnt[j] += cnt[recent];
                    }
                    else{
                        dis[j] = dis[recent]+G[recent][j];
                        cnt[j] = cnt[recent];
                    }
                }
            }
        }   
    }
}

int main(){
    scanf("%d%d", &N, &M);

    for (int i=1; i<=N; i++){
        for (int j=1; j<=N; j++){
            G[i][j] = INF;
        }
    }

    for (int i=1; i<=M; i++){
        int node1, node2, weig;
        scanf("%d%d%d", &node1, &node2, &weig);
        G[node1][node2] = min(G[node1][node2], weig);
    }

    dijkstra(1);

    if (dis[N] > INF){
        printf("No answer");
        return 0;
    }
    printf("%d %lld", dis[N], cnt[N]);
    return 0;
}

Record

\(what\ can\ I\ say?\) 抽象艺术出题人

T3 - 方程的解

P1771

Sol

首先,\(g(x)\) 可以直接上快速幂解决,即为求不定方程 \(\sum_{i=1}^k a_i= p\) 解的数量,\(p\) 是定值

题目要求 \(a_i (1 \le i \le k)\) 为正整数,即将 \(p\) 划分为 \(k\) 个正整数相加,这就是经典插板法;在 \(p-1\) 个空隙中插 \(k-1\) 个板,答案即为 \(C_{p-1}^{k-1}\),别忘了上高精度,\(k\) 很小,一个一个乘完再一个一个除即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
#define ll long long
const int MOD = 1000, MAXL = 5e3+5;

int k, x, bas;
int ans[MAXL];

int QuickPow(int a, int b){
    ll res = 1;
    while (b){
        if (b&1) res = (res*a)%MOD;
        a = (a*a)%MOD;
        b >>= 1;
    }
    return res;
}

void mul(int x){
    int i;
    for (i=1; i<=5e3; i++){
        ans[i] = ans[i]*x;
    }
    for (i=1; i<=5e3; i++){
        ans[i+1] += ans[i]/10;
        ans[i] = ans[i]%10;
    }
}

void div(int x){
    int i, len, m;
    for (len=5e3; ans[len]==0&&len>=1; len--);  
    for (i=len, m=0; i>=1; i--){
        int tmp = ans[i];
        ans[i] = (m*10+tmp)/x;
        m = (m*10+tmp)%x;
    }
}

void prt(){
    int i;
    for (i=5e3; ans[i]==0&&i>1; i--);
    for (; i>=1; i--){
        printf("%d", ans[i]);
    }
}

int main(){
    scanf("%d%d", &k, &x);
    bas = QuickPow(x%MOD, x)-1;

    ans[1] = 1;
    for (int i=0; i<k-1; i++){
        int recent = bas-i; 
        mul(recent);
    }
    // prt();
    // cout << endl;
    for (int j=2; j<=k-1; j++){
        div(j);
    }
    prt();
    return 0;
}

Record

高精度不能忘啊,高精除单精还是得会的(

T4 - 染色

P3177

Sol

答案即求 \(\sum_{color} \sum_{1 \le i < j \le n} \sum_{e \in \delta(i, j)} w(e)\),其中 \(i\) 与 \(j\) 都染了 \(color\) 这一颜色,\(\delta(i, j)\) 表示 \(i\) 与 \(j\) 间的简单路径;我们尝试求和换序,即求 \(\sum_{e \in tree} w(e) \sum_{color} \sum_{1 \le i < j \le n}\),其中 \(\delta(i, j)\) 包含 \((s, t)\);因此转化为统计 树上有多少同色点经过一条边

考虑记录 \(dp[i][j]\) 表示节点 \(i\) 的子树内有 \(j\) 个点染成黑色的最大贡献;对于当前节点 \(i\) 与其的一个孩子 \(child\),设在 \(child\) 中选 \(k\) 个点染黑,则边 \((i, child)\) 会产生两部分贡献;黑色点的贡献为 \(k \times (m-k) \times w(e)\),白色点的贡献为 \((siz[child]-k) \times (n-siz[child]-(m-k)) \times w(e)\) 其中 \(siz\) 表示子树大小;两部分加起来即为该边产生的贡献,记为 \(val\);

设在当前节点 \(i\) 选 \(j\) 个染黑,在儿子 \(child\) 中选 \(k\) 个点染黑,则转移方程为 \(dp[i][j] = max(dp[i][j-k]+dp[child][k]+val)\);注意需要倒序枚举 \(j\),否则会产生重复贡献,与 \(01\) 背包滚动数组的原理类似

注意 \(int \times int\) 时爆 \(long long\)

代码

C++
#include<bits/stdc++.h>
using namespace std;
#define ll long long
const int MAXN = 2005, MAXM = 2005;

int n, m;

struct Edge{
    int to;
    int weig;
};

vector <Edge> G[MAXN];
ll dp[MAXN][MAXM];
int siz[MAXN];

void dfssiz(int node, int fa){
    siz[node] = 1;
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i].to == fa) continue;
        dfssiz(G[node][i].to, node);
        siz[node] += siz[G[node][i].to];        
    }
}

void dfs(int node, int fa){
    dp[node][0] = dp[node][1] = 0;
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i].to == fa) continue;
        dfs(G[node][i].to, node);
        for (int j=min(siz[node], m); j>=0; j--){
            for (int k=0; k<=min(siz[G[node][i].to], j); k++){
                if (dp[node][j-k] == -1) continue;
                ll cnt = ((siz[G[node][i].to]-k)*(n-siz[G[node][i].to]-(m-k)))*(ll)G[node][i].weig + k*(m-k)*(ll)G[node][i].weig;
                dp[node][j] = max(dp[node][j], dp[node][j-k]+dp[G[node][i].to][k]+cnt);
            }
        }
    }
}

int main(){
    scanf("%d%d", &n, &m);

    for (int i=1; i<=n-1; i++){
        int node1, node2, weig;
        scanf("%d%d%d", &node1, &node2, &weig);
        G[node1].push_back({node2, weig});
        G[node2].push_back({node1, weig});
    }

    memset(dp, -1, sizeof(dp));

    dfssiz(1, 1);
    dfs(1, 1);

    printf("%lld", dp[1][m]);
    return 0;
}

Record

这 \(dp\) 向来是会不了一点的;考场上注意读题!写链的部分分的时候糊的 \(dp\) 只考虑了一种颜色的点,什么实力(

2024.7.21 模拟赛(CSPS2022)记录

T1 - P8817

P8817

Sol

首先,我们显然要预处理出每两个点需要换乘几次车,这个容易通过在每一个点跑一次 \(bfs\) 得出,时间复杂度 \(O(n^2)\),可以接受;

我们考虑贪心,从节点 \(1\) 走到离可以走到的最大价值点,再从这个最大价值点走到下一个最大价值点……但这样对吗?好像有点问题;我们走到当前最大价值点时,实际上对下一步的范围有影响,进而影响下一步能走到的最大价值点,因此有后效性,不能直接贪;但是我们如果枚举每个点,\(O(n^4)\) 的时间复杂度显然无法接受,所以我直接暴力跑路

考虑优化我们的贪心;什么时候不会产生后效性?这个简单, 后面没有点 了呗,因此设路径为 \(1-a-b-c-d-1\),当我们确定 \(a,b,c\) 时,就可以贪 \(d\);又注意到整个路径是对称的,因此我们 把整个路径分为两组,即 \(\{a, b\}\) 与 \(\{c, d\}\);在确定 \(b\) 时可以贪 \(a\),在确定 \(c\) 时可以贪 \(d\)

因此,我们还要处理出确定一个点 \(node\) 时,可以到达点 \(node\) 且可以到达点 \(1\) 的最大价值点;这其实可以在开始的 \(bfs\) 中一并处理,具体的,当我们确定点 \(node\) 可达 \(i\) 时,再判断点 \(1\) 是否可达 \(i\);我们记录这样可达的点 \(i\),直接排序即可

问题是,我们如果记录下所有的点 \(i\),那时间复杂度又炸了;怎么办?其实不需要用这么多点的,设已知点 \(b\),点 \(i\) 只可能与点 \(c\)、点 \(d\) 重合,因此最多跳 \(2\) 次,所以我们只需要记录下 \(3\) 个这样的点 \(i\) 即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 2505, MAXL = 5e5+5;

int n, m, k, front, rear;
long long ans;
long long w[MAXN];
vector <int> G[MAXN];

struct Node{
    int node;
    int step;
}q[MAXL];

bool vis[MAXN];
bool cget[MAXN][MAXN];
vector <int> mget[MAXN];

bool cmp(int a, int b){
    return w[a]>w[b];
}

void bfs(int start){
    memset(vis, false, sizeof(vis));
    vis[start] = true;
    front = rear = 0;
    q[rear].node = start;
    q[rear].step = 0;
    rear++;

    while (front != rear){
        int rnode = q[front].node;
        int rstep = q[front].step;
        front++;

        if (rnode != start){
            cget[start][rnode] = true;
            if (cget[1][rnode] == true){
                mget[start].push_back(rnode);
                sort(mget[start].begin(), mget[start].end(), cmp);
                if (mget[start].size() >= 4) mget[start].pop_back();
            }
        }
        if (rstep > k) continue;
        for (int i=0; i<G[rnode].size(); i++){
            if (vis[G[rnode][i]] == false){
                vis[G[rnode][i]] = true;
                q[rear].node = G[rnode][i];
                q[rear].step = rstep+1;
                rear++;
            }
        }
    }
}

int main(){
    scanf("%d%d%d", &n, &m, &k);
    for (int i=2; i<=n; i++){
        scanf("%lld", &w[i]);
    }
    for (int i=1; i<=m; i++){
        int node1, node2;
        scanf("%d%d", &node1, &node2);
        G[node1].push_back(node2);
        G[node2].push_back(node1);
    }

    for (int i=1; i<=n; i++){
        bfs(i);
    }

    for (int i=2; i<=n; i++){
        for (int j=2; j<=n; j++){
            if (i == j || cget[i][j] == false) continue;
            for (int p=0; p<mget[i].size(); p++){
                for (int q=0; q<mget[j].size(); q++){
                    if (i == mget[i][p] || i == mget[j][q] || j == mget[i][p] || j == mget[j][q] || mget[i][p] == mget[j][q]){
                        continue;
                    }
                    ans = max(ans, w[i]+w[j]+w[mget[i][p]]+w[mget[j][q]]);
                }
            }
        }
    }

    printf("%lld", ans);
    return 0;
}

Record

赛时可真是抽象...打完 \(40pts\) 纯 \(O(n^4)\) 暴力后就直接开后面的题,浪费了太多时间;虽然最后也没有想出正解,但也没有时间交上优化后的暴力,比赛前 \(1min\) 卡线没交上,\(60pts \rightarrow 45pts\);所以还是记得别太极限……

T2 - P8818

P8818

简单题。我们考虑对 \(a[i] (l_1 \le i \le r_1)\) 全正/全负/有正有负 进行分讨,对于 \(b[i] (l_2 \le i \le r_2)\) 同理,过程应该可以优化,但这么讨论最直接,适合我这种没脑子的人

分讨中,我们发现需要记录 \(a[i]\) 任意区间的最大值 / 最小值 / 非负数最小值 / 非正数最大值、\(b[i]\) 任意区间的最大值 / 最小值,直接枚举显然会炸,上相关数据结构即可,线段树或者 \(ST\) 表都行;

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5, MAXLOG = 20, INF = 1e9;

int n, m, q, l1, r1, l2, r2, len1, len2;
long long m1, m2, m3, m4, m5, m6, m7, m8;
long long a[MAXN], b[MAXN], log_2[MAXN];
long long c1[MAXN][MAXLOG], c2[MAXN][MAXLOG], c3[MAXN][MAXLOG], c4[MAXN][MAXLOG];
long long d1[MAXN][MAXLOG], d2[MAXN][MAXLOG];

void init(){
    log_2[1] = 0;
    log_2[2] = 1;

    for (int i=3; i<=max(n, m); i++){
        log_2[i] = log_2[i/2]+1;
    }
}

int main(){
    scanf("%d%d%d", &n, &m, &q);

    for (int i=1; i<=n; i++){
        scanf("%lld", &a[i]);
        c1[i][0] = a[i];
        c2[i][0] = a[i];
        if (a[i]==0) c3[i][0] = a[i], c4[i][0] = a[i];
        else if (a[i]>0) c3[i][0] = a[i], c4[i][0] = -INF;
        else if (a[i]<0) c3[i][0] = INF, c4[i][0] = a[i];
    }
    for (int i=1; i<=m; i++){
        scanf("%lld", &b[i]);
        d1[i][0] = b[i];
        d2[i][0] = b[i];
    }

    init();

    for (int j=1; j<=MAXLOG; j++){
        for (int i=1; (i+(1<<j)-1)<=n; i++){
            c1[i][j] = max(c1[i][j-1], c1[i+(1<<(j-1))][j-1]);
            c2[i][j] = min(c2[i][j-1], c2[i+(1<<(j-1))][j-1]);
            c3[i][j] = min(c3[i][j-1], c3[i+(1<<(j-1))][j-1]);
            c4[i][j] = max(c4[i][j-1], c4[i+(1<<(j-1))][j-1]);

        }   
    }   
    for (int j=1; j<=MAXLOG; j++){
        for (int i=1; (i+(1<<j)-1)<=m; i++){
            d1[i][j] = max(d1[i][j-1], d1[i+(1<<(j-1))][j-1]);
            d2[i][j] = min(d2[i][j-1], d2[i+(1<<(j-1))][j-1]);
        }   
    }   

    for (int i=1; i<=q; i++){
        scanf("%d%d%d%d", &l1, &r1, &l2, &r2);
        len1 = r1-l1+1;
        len2 = r2-l2+1;
        m1 = max(c1[l1][log_2[len1]], c1[r1-(1<<log_2[len1])+1][log_2[len1]]);
        m2 = min(c2[l1][log_2[len1]], c2[r1-(1<<log_2[len1])+1][log_2[len1]]);
        m3 = max(d1[l2][log_2[len2]], d1[r2-(1<<log_2[len2])+1][log_2[len2]]);
        m4 = min(d2[l2][log_2[len2]], d2[r2-(1<<log_2[len2])+1][log_2[len2]]);
        m5 = min(c3[l1][log_2[len1]], c3[r1-(1<<log_2[len1])+1][log_2[len1]]);
        m6 = max(c4[l1][log_2[len1]], c4[r1-(1<<log_2[len1])+1][log_2[len1]]);
        // cout << m1<< " " << m2 << " " << m3 << " " << m4 << " " << m5 << " " << m6 << endl;
        if (m3 <= 0){
            if (m1 <= 0) printf("%lld\n", m2*m3);
            else if (m2 >= 0) printf("%lld\n", m2*m4);
            else printf("%lld\n", m2*m3);
        }
        else if (m4 >= 0){
            if (m1 <= 0) printf("%lld\n", m1*m3);
            else if (m2 >= 0) printf("%lld\n", m1*m4);
            else printf("%lld\n", m1*m4);
        }
        else{
            if (m1 <= 0) printf("%lld\n", m1*m3);
            else if (m2 >= 0) printf("%lld\n", m2*m4);
            else printf("%lld\n", max(m3*m6, m4*m5));       
        }
    }
    return 0;
}

Record

这题本身没什么难度,主要想说说拍子的事……写了个 \(py\) 文件当生成器,结果运行时写成 \(python3 \ xxx.py\),电脑恰好没 \(python3\),再加上我眼瞎把提示看成 \(fc\) 的提示 (什么实力),愣是一直没发现……\(1h\) 后才发现并改成了 \(python \ xxx.py\);

T3 - P8819

P8819

一个节点 \(i\) 能实现反击,意味着从 \(i\) 可以走到一个环;能实现连续穿梭,意味着图中所有节点的出度都是 \(1\);事实上,所有节点的出度都是 \(1\) 已经包含从任意节点 \(i\) 都能走到环这一条件,因此我们 只需要记录出度

对于操作 \(1\) 与操作 \(3\),很容易维护;但是对于操作 \(2\) 与操作 \(4\) 不太好办,因为我们删除或者恢复一个点,操作的是这个节点的入边;如果我们枚举每个与 \(i\) 连边的点,时间开销太大,无法接受;由于操作 \(1\) 与操作 \(3\) 对于入度也很容易维护,因此我们考虑 改为维护入度

出度与入度有什么关系?有一个显然的基本定理:所有点的入度之和等于所有点的出度之和;因此,如果我们已知所有点的入度之和,可以保证结果的 正确性,但是,此时充分性无法保证;例如,我们知道 \(1+1+1+1=4\),但是只知道和是 \(4\),无法确定每个点的出度都是 \(1\);这里是关键点:我们 考虑哈希与随机化的思想

原来所有点的出度都是 \(1\),算出和来不好反推;我们将 每个点随机赋一个值,代表其入度;记录其一开始的入度之和,如果某次操作后当前所有点的入度之和等于开始的入度之和,那么我们就可以认为此时满足要求

实现时,开一个变量实时维护所有点的入度之和,我们承受不了每次操作后再加在一块统计的时间开销……

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 5e5+5;

int n, m, q, node1, node2, op;
unsigned int s=0, rs=0;
unsigned int w[MAXN], in[MAXN], r[MAXN];

int main(){
    srand(time(0));
    scanf("%d%d", &n, &m);
    for (int i=1; i<=n; i++){
        w[i] = (unsigned int)rand();
        s += w[i];
    }
    for (int i=1; i<=m; i++){
        scanf("%d%d", &node1, &node2);
        r[node2] += w[node1];
        in[node2] += w[node1];
        rs += w[node1];
    }
    scanf("%d", &q);
    for (int i=1; i<=q; i++){
        scanf("%d", &op);
        if (op == 1){
            scanf("%d%d", &node1, &node2);
            in[node2] -= w[node1];
            rs -= w[node1];
        }
        else if (op == 2){
            scanf("%d", &node1);
            rs -= in[node1];
            in[node1] = 0;
        }
        else if (op == 3){
            scanf("%d%d", &node1, &node2);
            in[node2] += w[node1];
            rs += w[node1];
        }
        else if (op == 4){
            scanf("%d", &node1);
            rs += r[node1]-in[node1];
            in[node1] = r[node1];
        }
        if (rs == s){
            printf("YES\n");
        }
        else{
            printf("NO\n");
        }
    }
    return 0;
}

Record

太菜了,考试的时候直接照着最暴力的部分打,甚至没有考虑要求 \(1\) 实际上没有意义;\(40pts \rightarrow 25pts\);不过这题的正解思想确实精妙,现在根本没有这个实力……

T4 - P8820

P8820

不会捏。\(44pts\) 暴力跑路;其实如果纯写暴力,对于我这种 \(dp\) 极度不好的人来说没有必要去写 \(dp\),直接暴力建图 + 堆优化 \(dij\) 即可,时间复杂度可能还要更优……

树形DP基础 做题记录

P2015

P2015

典型的树上背包模型。我们设 \(dp[i][j]\) 表示在以 \(i\) 为根的子树中保留 \(j\) 条边的最大价值;按照树形 \(DP\) 的一般套路,在节点 \(node\) 处,首先递归搜索儿子的子树,再进行转移;

转移时,设 \(j\) 为当前以 \(node\) 为根的子树选择的边数,\(k\) 为以 \(child\) 为根的子树选择的边数,连接节点 \((i, j)\) 的边的权值为 \(val[i][j]\),转移方程即为 \(dp[node][j] = \sum_{child \in son(node)}max(dp[node][j-k-1]+dp[child][k]+val[node][child])\),注意这里因为 还有 \((node, child)\) 的一条边,所以转移方程中第二维 \(j-k-1\) 与 \(k\) 的和是 \(j-1\) 而非 \(j\)

实现时,我们可以考虑记录节点 \(i\) 子树中边的个数 \(siz[i]\),方便判断边界;\(siz[i]\) 的转移方程为 \(siz[node] = \sum_{child \in son(node)}siz[child]+1\),同样别忘了考虑 \((node, child)\) 的一条边

答案即为 \(dp[1][Q]\)

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 105, MAXQ = 105;

struct Edge{
    int to;
    int weig;
};

int N, Q;
vector <Edge> G[MAXN];
int dp[MAXN][MAXQ], siz[MAXN];

void dfs(int node, int fa){
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i].to == fa) continue;
        dfs(G[node][i].to, node);
        siz[node] += siz[G[node][i].to]+1;
        for (int j=min(siz[node], Q); j>=1; j--){
            for (int k=0; k<=min(siz[G[node][i].to], j-1); k++){
                dp[node][j] = max(dp[node][j], dp[node][j-k-1]+dp[G[node][i].to][k]+G[node][i].weig);
            }
        }
    }
}

int main(){
    scanf("%d%d", &N, &Q);

    for (int i=1; i<=N-1; i++){
        int node1, node2, weig;
        scanf("%d%d%d", &node1, &node2, &weig);
        G[node1].push_back({node2, weig});
        G[node2].push_back({node1, weig});
    }

    dfs(1, 1);
    printf("%d", dp[1][Q]);
    return 0;
}

P2014

P2014

仍然是树上背包问题。转移方程与 \(P2015\) 是类似的;实现时,有几个细节略有不同;我们将每门课的先修课向该课连边,最终会形成一个森林,如果我们依次 \(dp\) 每棵树并统计不太方便,因此考虑 增加一个 \(0\) 号点,作为所有没有先修课的课程的先修课,设其价值为 \(0\),再进行树形 \(DP\) 即可;别忘了我们在这里增加了一个点,对枚举的上界与最终的答案选择会产生影响

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 105;

int N, M;
vector <int> G[MAXN];
int dp[MAXN][MAXN], siz[MAXN], in[MAXN], w[MAXN];

void dfs(int node, int fa){
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        dfs(G[node][i], node);
        siz[node] += siz[G[node][i]]+1;
        for (int j=min(M+1, siz[node]); j>=1; j--){
            for (int k=1; k<=min(siz[G[node][i]], j-1); k++){
                dp[node][j] = max(dp[node][j], dp[node][j-k]+dp[G[node][i]][k]);
            }
        }
    }
}

int main(){
    scanf("%d%d", &N, &M);

    w[0] = 0;
    for (int i=1; i<=N; i++){
        int node, weig;
        scanf("%d%d", &node, &weig);
        G[node].push_back(i);
        in[i]++;
        w[i] = weig;
    }

    for (int i=1; i<=N; i++){
        if (in[i] == 1) siz[i]++;
        dp[i][1] = w[i];
    }

    dfs(0, 0);
    printf("%d", dp[0][M+1]);
    return 0;
}

BNDSOJ DP-5-3 祖孙询问

DP-5-3 祖孙询问

可以使用 \(LCA\) 卡过,如果 \(x\) 是 \(y\) 的祖先那么 \(lca(x, y) = x\),如果 \(y\) 是 \(x\) 的祖先那么 \(lca(x, y) = y\),如果都不是那么 \(lca(x, y)\) 既不是 \(x\) 也不是 \(y\);

但是,这道题中只需要判断 \(x\) 与 \(y\) 是否在同一子树中,没有必要使用 \(LCA\);我们考虑与 \(Tarjan\) 类似的思想,在对树进行 \(dfs\) 时,我们开两个数组 \(in[i], out[i]\),分别表示节点 \(i\) 什么时候第一次被遍历,\(i\) 什么时候退出遍历;

对于节点 \(i\) 与 \(j\),如果 \(i\) 是 \(j\) 的祖先,那么 一定有 \(in[i] < in[j]\ \&\&\ out[i] \ge out[j]\),证明是显然的;如果两节点不在一个子树中,那么两节点的 \(in, out\) 区间不交

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int n, m, s, diff=0;
int in[MAXN], out[MAXN];
vector <int> G[MAXN];

void dfs(int node, int fa){
    diff++;
    in[node] = diff;
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        dfs(G[node][i], node);
    }
    out[node] = diff;
}

int main(){
    scanf("%d", &n);

    for (int i=1; i<=n; i++){
        int node1, node2;
        scanf("%d%d", &node1, &node2);
        if (node2 == -1){
            s = node1; 
            continue;
        }
        G[node1].push_back(node2);
        G[node2].push_back(node1);
    }

    dfs(s, s);

    scanf("%d", &m);

    for (int i=1; i<=m; i++){
        int node1, node2;
        scanf("%d%d", &node1, &node2);
        if (in[node1] < in[node2] && out[node1] >= out[node2]) printf("1\n");
        else if (in[node1] > in[node2] && out[node1] <= out[node2]) printf("2\n");
        else printf("0\n");
    }
    return 0;
}

BNDSOJ DP-5-5 容易题

DP-5-5 容易题

由于我们从一个点开始 \(dfs\),达到的最远点必定是直径的一个端点,因此先求出直径 \(\delta(s, t)\),再分别以 \(s\) 与 \(t\) 为根进行两次 \(dfs\) 求出其他点到这两点的距离即可;对于点 \(node\),答案即为 \(max\{\delta(node, s), \delta(node, t)\}\)

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 10005;

int N, c, node1, node2;
int d[MAXN], d1[MAXN], d2[MAXN];
vector <int> G[MAXN];

void dfs(int node, int fa){
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        d[G[node][i]] = d[node]+1;
        if (d[G[node][i]] > d[c]) c = G[node][i];
        dfs(G[node][i], node);
    }   
}

void get1(int node, int fa){
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        d1[G[node][i]] = d1[node]+1;
        get1(G[node][i], node);
    }
}
void get2(int node, int fa){
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        d2[G[node][i]] = d2[node]+1;
        get2(G[node][i], node);
    }
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N-1; i++){
        int node1, node2;
        scanf("%d%d", &node1, &node2);
        G[node1].push_back(node2);
        G[node2].push_back(node1);
    }

    dfs(1, 1);
    d[c] = 0;
    node1 = c;
    dfs(c, c);
    node2 = c;

    get1(node1, node1);
    get2(node2, node2);

    for (int i=1; i<=N; i++){
        printf("%d\n", max(d1[i], d2[i]));
    }
    return 0;
}

P2016

P2016

题意即为求给定树的最小点覆盖;我们注意到,一条边的两个端点至少要选一个,因此设 \(dp[i][0/1]\) 表示在点 \(i\) 处设置 / 不设置士兵所花的最小代价;

转移方程即为 \(dp[i][1] = \sum_{v \in son(i)}min(dp[v][0], dp[v][1])\),\(dp[i][0] = \sum_{v \in son(i)}dp[v][1]\),在 \(dfs\) 转移前别忘了设初值 \(dp[i][1] = 1\)

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 2e3+5, INF = 2e9;

int n, id, k, node;
vector <int> G[MAXN];
int dp[MAXN][2];

void dfs(int node, int fa){
    dp[node][1] = 1;
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        dfs(G[node][i], node);
        dp[node][1] += min(dp[G[node][i]][0], dp[G[node][i]][1]);
        dp[node][0] += dp[G[node][i]][1];
    }
}

int main(){
    scanf("%d", &n);

    for (int i=1; i<=n; i++){
        scanf("%d%d", &id, &k);
        for (int i=1; i<=k; i++){
            scanf("%d", &node);
            G[id].push_back(node);
            G[node].push_back(id);
        }
    }

    dfs(0, 0);
    printf("%d", min(dp[0][0], dp[0][1]));
    return 0;
}

P2458

P2458

与上一道题略有不同,上一道题希望覆盖所有的边,这道题希望覆盖所有的点;由于一个点被覆盖可能通过三种方式,我们考虑设 \(dp[i][0/1/2]\),表示在该点处设置保安 / 在该点的 父亲 处设置保安 / 在该点的 儿子 处设置保安的最小代价

我们一个一个来看,对于 \(dp[i][0]\),由于当前节点已经被覆盖,儿子节点 可以选择任意方式,因此转移方程为 \(dp[i][0] = \sum_{v \in son(i)}min(dp[v][0], dp[v][1], dp[v][2])\)

对于 \(dp[i][1]\),设此时 \(i\) 的孩子为 \(v\),由于 \(i\) 现在并没有设置保安,因此 不能通过 \(dp[v][1]\) 转移而来;因此把这种情况挖掉,转移方程即为 \(dp[i][1] = \sum_{v \in son(i)}min(dp[i][0], dp[i][2])\)

对于 \(dp[i][2]\),同理此时不能通过 \(dp[v][1]\) 转移而来,因此转移方程即为 \(dp[i][2] = \sum_{v \in son(i)}min(dp[i][0], dp[i][2])\) ……了吗?事情没有这么简单;我们发现,如果节点 \(i\) 的 所有儿子 \(v\) 都选择通过 \(v\) 的儿子来覆盖 (即通过 \(dp[v][2]\) 转移而来),那么实际上所有的儿子 \(v\) 上都没有保安,这与状态设计不符;这种情况下,我们只能考虑选取一个儿子 \(v\),将由 \(dp[v][2]\) 转移换成由 \(dp[v][0]\) 转移,因此我们也要在转移时 记录每个儿子 \(dp[v][0]-dp[v][2]\) 的最小值 \(extra\),最终特判如果全都选择由 \(dp[v][2]\) 转移而来,则将结果加上 \(extra\)

实现时,别忘了将叶子节点的 \(dp[i][2]\) 设为 \(+\infty\),同时将每个 \(dp[i][0]\) 赋初值 \(v[i]\)

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 2005, INF = 1e9;

int n, start, id, k, m, child, cover;
int r[MAXN];
bool nroot[MAXN], leaf[MAXN];

vector<int>G[MAXN];
long long dp[MAXN][3];

void dfs(int node){
    dp[node][0] = r[node];
    bool flag = true;
    long long cover = 1ll*INF;

    for (int i=0; i<G[node].size(); i++){
        dfs(G[node][i]);

        dp[node][0] += min(dp[G[node][i]][0], min(dp[G[node][i]][1], dp[G[node][i]][2]));
        dp[node][1] += min(dp[G[node][i]][0], dp[G[node][i]][2]);

        if (dp[G[node][i]][0] < dp[G[node][i]][2]){
            flag = false;
            dp[node][2] += dp[G[node][i]][0];
        }
        else{
            cover = min(1ll*cover, dp[G[node][i]][0]-dp[G[node][i]][2]);
            dp[node][2] += dp[G[node][i]][2];
        }
    }

    if (flag == true){
        dp[node][2] += cover;
    }
}

int main(){
    scanf("%d", &n);

    for (int i=1; i<=n; i++){
        scanf("%d%d%d", &id, &k, &m);
        r[id] = k;
        if (m == 0) leaf[id] = true;
        for (int i=1; i<=m; i++){
            scanf("%d", &child);
            nroot[child] = true;
            G[id].push_back(child);
        }
    }

    for (int i=1; i<=n; i++){
        if (leaf[i] == true){
            dp[i][2] = INF; 
        }
        if (nroot[i] == false){
            start = i;
        }
    }

    dfs(start);
    printf("%lld", min(dp[start][0], dp[start][2]));
    return 0;
}

BNDSOJ DP-5-8 旅游规划

DP-5-8 旅游规划

题意为让我们求出所有在直径上的节点 (直径可能有很多条);显然只按常规操作进行二次 \(dfs\) 无法解决问题 (因为只能求出一条直径上的节点),但又因为暴力选取每个点分别进行 \(dfs\) 时间复杂度为 \(O(n^2)\),会超时,我们希望优化算法

首先,注意到任选树上一节点 \(s\) 进行 \(dfs\),到达的节点肯定是直径的端点,这很显然,反证即可;我们在 \(dfs\) 中维护以 \(s\) 为根时所有节点的深度 \(d[i]\) 与最终直径的长度 \(maxd\),搜索完成后枚举每个节点 \(i\),记录下所有 \(d[i] = maxd\) 的节点 \(i\);由于我们可以任意选取直径,易知所有的节点 \(i\) 都为某一条直径的端点,同时,所有的直径都至少有一个端点在这些节点中

接下来,如果对于每个端点都再进行一次 \(dfs\),仍然会超时;我们考虑只选取一个端点 \(node\) 再进行 \(dfs\),按照同样的方法记录下所有离 \(node\) 最远的节点 \(k\);同理,所有的节点 \(k\) 也都为某一条直径的端点;又因为 所有直径中点都相交,则 所有的节点 \(k\) 和所有的节点 \(i\) 已经覆盖了所有的直径的端点;

现在我们已经得到了所有的直径的端点,但题目让我们求所有直径上的点,怎么办呢?我们 在第二次 \(dfs\) 中 考虑记录每个节点的父亲,依次往上跳即可;那为什么可以覆盖所有直径上的点?我们设一条直径为 \(\delta(s, t)\),另一条为 \(\delta(p, q)\),现在我们将节点 \(s\) 作为根跑 \(dfs\),由上,易知 \(\delta(s, t)\) 与 \(\delta(p, q)\) 有交点,设为 \(mid\),在 \(\delta(p, s)\) 上的所有节点,都能够在 \(p \rightarrow mid \rightarrow s\) 这么跳时被覆盖,同理在 \(\delta(q, s)\) 上的所有节点都能够在 \(q \rightarrow mid \rightarrow s\) 这么跳时被覆盖;因此证毕

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 2e5+5;

int n, maxd, nod;
int d[MAXN], jump[MAXN];
vector <int> G[MAXN];
set <int> res, ans;

void dfs(int node, int fa){
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        d[G[node][i]] = d[node]+1;
        if (d[G[node][i]] > maxd) maxd = d[G[node][i]];
        dfs(G[node][i], node);
    }
}
void dfs2(int node, int fa){
    jump[node] = fa;
    for (int i=0; i<G[node].size(); i++){
        if (G[node][i] == fa) continue;
        d[G[node][i]] = d[node]+1;
        if (d[G[node][i]] > maxd) maxd = d[G[node][i]];
        dfs2(G[node][i], node);
    }
}

int main(){
    scanf("%d", &n);

    for (int i=1; i<=n-1; i++){
        int node1, node2;
        scanf("%d%d", &node1, &node2);
        G[node1].push_back(node2);
        G[node2].push_back(node1);
    }

    dfs(0, -1);
    for (int i=1; i<=n; i++){
        if (d[i] == maxd){
            nod = i;
            res.insert(i);
        }
    }
    maxd = 0, d[nod] = 0;
    dfs2(nod, -1);
    for (int i=1; i<=n; i++){
        if (d[i] == maxd){
            res.insert(i);
        }
    }
    for (auto i=res.begin(); i!=res.end(); i++){
        int recent = (*i);
        while (recent != -1){
            ans.insert(recent);
            recent = jump[recent];
        }
    }
    for (auto i=ans.begin(); i!=ans.end(); i++){
        printf("%d\n", (*i));
    }
    return 0;
}

2024.7.17 训练记录

BNDSOJ USACO - Connect The Cows

Connect The Cows

一开始拿到这道题,脑残直接开始一格一格 \(dfs\),难想、复杂又容易写错……实际上,由于约翰 只会在牛处转向,我们只需要在原点 \((0, 0)\) 和牛之间 \(dfs\) 即可

我们枚举每只牛的坐标,如果有两只牛 \(x\) 坐标相同或 \(y\) 坐标相同就在它们之间连边;注意,如果牛的 \(x\) 坐标为 \(0\) 或 \(y\) 坐标也为 \(0\),也别忘了在它与原点之间连边

\(dfs\) 时,我们记录当前节点编号、方向 与经过的牛的数量;别忘了记录方向!枚举与当前点直接连边的点,特判下个点是 \(0\) 且已经经过所有牛 的情况 (因为如果没有经过所有牛回到原点是没有意义的,反正也无法改变方向);若下个点为牛,必须转向,无需考虑不改变方向的情况 (假设从起始牛的位置向下走到中间牛,如果中间牛处不改变方向,只有在该头牛下方还有一头牛时有意义;又由于我们的连边操作,起始牛一定会向这一头牛连一条边,因此如果我们考虑不改变方向的情况,答案会被重复计算

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 15;

int N, ans;

struct Cow{
    int x;
    int y;
}cow[MAXN];

struct Edge{
    int to;
    int dir;
};

vector <Edge> G[MAXN];

void show(){
    cout << "show: " << endl;
    for (int i=0; i<=N; i++){
        for (int j=0; j<G[i].size(); j++){
            cout << i << " " << G[i][j].to << ", dir = " << G[i][j].dir << endl;
        }
    }
}

bool vis[MAXN];

void dfs(int node, int dir, int cnt){
    if (node == 0 && cnt == N+1){
        ans++;
        return; 
    }

    for (int i=0; i<G[node].size(); i++){
        if (dir == G[node][i].dir){
            if (G[node][i].to == 0 && cnt == N+1){
                dfs(G[node][i].to, dir, cnt);
            }

            if (G[node][i].to != 0 && vis[G[node][i].to] == false){
                vis[G[node][i].to] = true;
                for (int j=0; j<4; j++){
                    if (j != dir){
                        dfs(G[node][i].to, j, cnt+1);
                    }   
                }
                vis[G[node][i].to] = false;
            }
        }
    }   
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d%d", &cow[i].x, &cow[i].y);
        if (cow[i].x == 0){
            if (cow[i].y > 0){
                G[0].push_back({i, 0});
                G[i].push_back({0, 2});
            }
            else{
                G[0].push_back({i, 2});
                G[i].push_back({0, 0});
            }
        }
        else if (cow[i].y == 0){
            if (cow[i].x > 0){
                G[0].push_back({i, 3});
                G[i].push_back({0, 1});
            }
            else{
                G[0].push_back({i, 1});
                G[i].push_back({0, 3});
            }
        }
    }

    for (int i=1; i<=N; i++){
        for (int j=i+1; j<=N; j++){
            if (cow[i].x == cow[j].x){
                if (cow[i].y > cow[j].y){
                    G[i].push_back({j, 2}); 
                    G[j].push_back({i, 0});
                }
                else{
                    G[i].push_back({j, 0});
                    G[j].push_back({i, 2});
                }
            }
            else if (cow[i].y == cow[j].y){
                if (cow[i].x > cow[j].x){
                    G[i].push_back({j, 1}); 
                    G[j].push_back({i, 3});
                }
                else{
                    G[i].push_back({j, 3});
                    G[j].push_back({i, 1});
                }
            }
        }
    }

    // show();

    vis[0] = true;
    dfs(0, 0, 1);
    dfs(0, 1, 1);
    dfs(0, 2, 1);
    dfs(0, 3, 1);
    printf("%d", ans);
    return 0;
}

BNDSOJ USACO - Wrong Directions

Wrong Directions

我们如果每次更改一个字符串,再从头扫一遍,时间复杂度为 \(O(n^2)\),显然会超时

我们优化暴力,考虑将原字符串分为三段,具体的,为更改的字符、更改的字符前段、更改的字符后段三段;我们考虑对长度为 \(N\) 的原字符串 \(s[i]\) 进行预处理,由于我们 只需要知道更改前段走到哪里、更改后段相较于原点的相对距离,因此预处理出 前缀位置数组 \(before[i]\),记录按照子串 \(s[1...i]\) 操作后走到的位置;再处理出 后缀位置数组 \(after[i]\),记录按照子串 \(s[i...N]\) 操作后走到的位置 (起始方向都默认向北);

我们发现,\(before[i]\) 数组是容易维护的,但由于 \(after[i]\) 数组是倒着处理的,不能按照常规方法维护;考虑分类讨论第 \(i\) 位的字符种类:

  1. 如果为 \(F\),那很好办,直接令 \(after[i].x = after[i+1].x\),\(after[i].y = after[i+1].y+1\) 即可,因为默认起始方向向北,向前走一步即为向北走一步,体现在 \(y\) 坐标的变化上
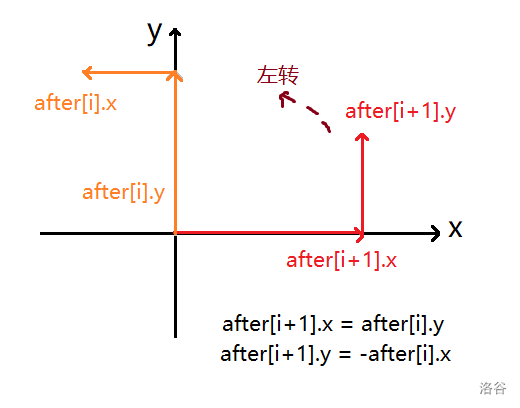
  2. 如果为 \(L\),那么原来的 \(y\) 移动量变成了现在的 \(x\) 移动量,原来的 \(x\) 移动量变成了现在的 \(y\) 移动量;至于方向,我们可以画个图辅助理解

左转图片

此时有 \(after[i].x = -after[i+1].y, after[i].y = after[i+1].x\)

  1. 如果为 \(R\),那么原来的 \(y\) 移动量还是变成了现在的 \(x\) 移动量,原来的 \(x\) 移动量也还是变成了现在的 \(y\) 移动量;其实图与左转时是相同的,只不过左转时的 \(after[i]\) 相当于右转时的 \(after[i+1]\)、左转时的 \(after[i+1]\) 相当于右转时的 \(after[i]\);类似的,此时有 \(after[i].x = after[i+1].y, after[i].y = -after[i+1].x\)

这样,我们就能够处理出 \(after[i]\) 数组了;实际更改第 \(i\) 位时,只需要先将位置变更为 \(before[i-1]\),讨论第 \(i\) 位的变化,再两坐标分别增加 \(after[i+1].x\)、\(after[i+1].y\) 即可;

实现时,注意我们在处理 \(after[i]\) 数组时默认方向向北,但更改字符时可能会改变方向,使方向不是北,因此我们需要考虑方向的变化;具体的,如果方向变成西 / 东,那相当于一次 左转 / 右转,否则相当于一次 按原点对称翻转

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

string s;
int ans;

map <int, map<int, bool> > vis;

struct Node{
    int x;
    int y;
    int dir;
}before[MAXN], after[MAXN];

pair<int, int> getnex(int x, int y, int dir){
    int nx, ny;

    if (dir == 0){
        nx = x;
        ny = y+1;
    }       
    else if (dir == 1){
        nx = x-1;
        ny = y;
    }
    else if (dir == 2){
        nx = x;
        ny = y-1;
    }
    else{
        nx = x+1;
        ny = y;
    }

    return {nx, ny};
}

pair <int, int> offset(int x, int y, int dir){
    if (dir == 1){
        return {-y, x};
    }
    if (dir == 0){
        return {x, y};
    }
    if (dir == 2){
        return {-x, -y};
    }
    if (dir == 3){
        return {y, -x};
    }
}

int main(){
    cin >> s;
    before[0].x = 0;
    before[0].y = 0;
    before[0].dir = 0;

    for (int i=1; i<=s.size(); i++){
        if (s[i-1] == 'L'){
            before[i] = before[i-1];
            before[i].dir = (before[i].dir+1)%4;
        }   
        else if (s[i-1] == 'R'){
            before[i] = before[i-1];
            before[i].dir = (before[i].dir+3)%4;
        }
        else{
            int nx, ny;
            nx = getnex(before[i-1].x, before[i-1].y, before[i-1].dir).first;
            ny = getnex(before[i-1].x, before[i-1].y, before[i-1].dir).second;
            before[i] = {nx, ny, before[i-1].dir};
        }
    }

    for (int i=s.size(); i>=1; i--){
        if (s[i-1] == 'L'){
            after[i].x = -after[i+1].y;
            after[i].y = after[i+1].x;
        }
        else if (s[i-1] == 'R'){
            after[i].x = after[i+1].y;
            after[i].y = -after[i+1].x;
        }
        else{
            after[i].x = after[i+1].x;
            after[i].y = after[i+1].y+1;
        }
    }

    for (int i=1; i<=s.size(); i++){
        int ansx = before[i-1].x, ansy = before[i-1].y, ansdir = before[i-1].dir;

        if (s[i-1] == 'F'){
            int offsetx = offset(after[i+1].x, after[i+1].y, (ansdir+1)%4).first;
            int offsety = offset(after[i+1].x, after[i+1].y, (ansdir+1)%4).second;
            int nx = ansx+offsetx;
            int ny = ansy+offsety;
            //cout << nx << " " << ny << endl;
            if (!vis[nx][ny]){
                vis[nx][ny] = true;
                ans++;
            }

            offsetx = offset(after[i+1].x, after[i+1].y, (ansdir+3)%4).first;
            offsety = offset(after[i+1].x, after[i+1].y, (ansdir+3)%4).second;
            nx = ansx+offsetx;
            ny = ansy+offsety;
            //cout << nx << " " << ny << endl;
            if (!vis[nx][ny]){
                vis[nx][ny] = true;
                ans++;
            }
        }
        else if (s[i-1] == 'L'){
            int offsetx = offset(after[i+1].x, after[i+1].y, (ansdir+3)%4).first;
            int offsety = offset(after[i+1].x, after[i+1].y, (ansdir+3)%4).second;
            int nx = ansx+offsetx;
            int ny = ansy+offsety;
            //cout << nx << " " << ny << endl;
            if (!vis[nx][ny]){
                vis[nx][ny] = true;
                ans++;
            }

            offsetx = offset(after[i+1].x, after[i+1].y+1, ansdir).first;
            offsety = offset(after[i+1].x, after[i+1].y+1, ansdir).second;
            nx = ansx+offsetx;
            ny = ansy+offsety;
            //cout << nx << " " << ny << endl;
            if (!vis[nx][ny]){
                vis[nx][ny] = true;
                ans++;
            }
        }
        else if (s[i-1] == 'R'){
            int offsetx = offset(after[i+1].x, after[i+1].y, (ansdir+1)%4).first;
            int offsety = offset(after[i+1].x, after[i+1].y, (ansdir+1)%4).second;
            int nx = ansx+offsetx;
            int ny = ansy+offsety;
            //cout << nx << " " << ny << endl;
            if (!vis[nx][ny]){
                vis[nx][ny] = true;
                ans++;
            }

            offsetx = offset(after[i+1].x, after[i+1].y+1, ansdir).first;
            offsety = offset(after[i+1].x, after[i+1].y+1, ansdir).second;
            nx = ansx+offsetx;
            ny = ansy+offsety;
            //cout << nx << " " << ny << endl;
            if (!vis[nx][ny]){
                vis[nx][ny] = true;
                ans++;
            }
        }
    }

    printf("%d", ans);
    return 0;
}

BNDSOJ USACO - Three Lines

Three Lines

看到题,想到一个看起来很对的贪心:我们按照每行有多少头牛从大到小排序、每列有多少头牛从大到小排序,删去牛最多的一行、牛最多的一列,再判断剩下的牛是否能够用一行或一列覆盖

我们感性理解一下这个贪心;如果我们用两行一列或两列一行删牛,一定会删一行或一列,那么对于删的这一行 / 一列,我们希望删完之后尽可能减小接下来再删列 / 行 的压力,因此我们删包含牛最多的一行 / 一列

这时候,你发现这样感性理解有一个很显然的漏洞:如果我们根本不用行或不用列,直接用三行 / 三列删牛怎么办?是的,贪心在这种情况下正确性无法保证,因此我们需要 特判使用三行或三列能否删掉所有牛

不特判的反例如下:

Text Only
1
2
3
CCC
 CC
CC
这样我们会删除第一行和第二列,剩余的牛无法用一行或一列覆盖;但实际上,我们直接用三行或者三列就可以删掉所有的牛

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 5e4+5;

int N, row, col, trow, tcol;

struct Cow{
    int x;
    int y;
}cow[MAXN];

map <int, bool> vis1, vis2, t1, t2;
map <int, int> rc, cr, rc2, cr2;

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d%d", &cow[i].x, &cow[i].y);
        if (vis1[cow[i].x] == false){
            vis1[cow[i].x] = true;
            row++;
        }
        if (vis2[cow[i].y] == false){
            vis2[cow[i].y] = true;
            col++;
        }
    }

    if (row <= 3 || col <= 3){
        printf("1");
        return 0;
    }

    for (int i=1; i<=N; i++){
        rc[cow[i].x]++;
        cr[cow[i].y]++;
    }
    for (auto it = rc.begin(); it != rc.end(); it++){
        rc2[(*it).second] = (*it).first;
    }
    for (auto it = cr.begin(); it != cr.end(); it++){
        cr2[(*it).second] = (*it).first;
    }
    auto brc = rc2.end();
    brc--;
    auto bcr = cr2.end();
    bcr--;
    int mrc = (*brc).second;
    int mcr = (*bcr).second;
    // cout << mrc << " " << mcr;

    for (int i=1; i<=N; i++){
        if (cow[i].x == mrc || cow[i].y == mcr){
            continue;
        }
        if (t1[cow[i].x] == false){
            t1[cow[i].x] = true;
            trow++;
        }
        if (t2[cow[i].y] == false){
            t2[cow[i].y] = true;
            tcol++;
        }
    }

    if (trow == 1 || tcol == 1){
        printf("1");
        return 0;
    }
    printf("0");
    return 0;
}

BNDSOJ USACO - Islands

Islands

我们考虑暴力,如果暴力枚举水的高度,然后扫一遍原序列统计岛屿的个数,时间复杂度为 \(O(HN)\),\(H\) 是值域,这里为 \(1e9\),显然会爆炸

我们发现值域实在是太大了,怎样避免枚举每个值呢?注意到,如果岛屿个数发生变化,临界点 必然是水的高度与之前某一还没有被淹没的陆机的高度相同时;又因为随着水位逐渐涨高,被淹没的陆地高度也会相应变高,因此我们 对陆地按照高度从小到大排序,依次处理淹没即可;这样时间复杂度变为 \(O(N^2)\),还是会超时

我们考虑优化如何统计岛屿个数。考虑水位上涨引起的岛屿个数的变化;具体的,设淹没前有 \(cnt\) 个岛屿,当前为第 \(i\) 块陆地被淹没,分情况讨论:

  1. 第 \(i-1\) 块与第 \(i+1\) 块陆地都被淹没,此时 \(cnt=cnt-1\)
  2. 第 \(i-1\) 块与第 \(i+1\) 块陆地有且仅有一块被淹没,此时 \(cnt\) 不变
  3. 第 \(i-1\) 块与第 \(i+1\) 块陆地都没有被淹没,此时 \(cnt=cnt+1\)

那么如果淹没的陆地的旁边是岸怎么办?没关系,初始时令第 \(0\) 块陆地 (左岸) 与第 \(N+1\) 块陆地 (右岸) 也被淹没,之后正常统计即可;这样维护每次更改的时间复杂度就为 \(O(1)\)

时间复杂度 \(O(NlogN)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int N, ans;
int h[MAXN];
bool deleted[MAXN];

struct Node{
    int val;
    int pos;
}sorth[MAXN];

bool cmp(Node a, Node b){
    return a.val < b.val;
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d", &h[i]);
        sorth[i].val = h[i];
        sorth[i].pos = i;
    }
    sort(sorth+1, sorth+N+1, cmp);
    deleted[0] = true;
    deleted[N+1] = true;

    int recenth = -1, cnt = 1;
    for (int i=1; i<=N; ){
        if (sorth[i].val != recenth){
            ans = max(ans, cnt);
            recenth = sorth[i].val;
        }   
        else{
            int delpos = sorth[i].pos;
            deleted[delpos] = true;
            if (deleted[delpos-1] && deleted[delpos+1]){
                cnt--;
            }
            else if ((!deleted[delpos-1]) && (!deleted[delpos+1])){
                cnt++;
            }
            i++;
        }
    }

    ans = max(ans, cnt);
    printf("%d", ans);
    return 0;
}

P5120 USACO - Convention II S

P5120

考虑按照题意模拟,令 \(topend\) 为当前吃草的牛吃完草的时间,\(cow[i].a\) 为第 \(i\) 头牛到达的时间,\(cow[i].t\) 为第 \(i\) 头牛吃草的时间;由于每次来的牛,按照资历 (即输入先后顺序) 排序,因此我们 定义一个优先队列,也按照输入先后顺序排序,模拟排队

当第 \(i\) 头牛到达时,我们分情况讨论如下:

  1. 草地上有牛在吃,那么让第 \(i\) 头牛直接入队等待

  2. 草地上没有牛在吃

2.1 队列中没有牛等待,直接让第 \(i\) 头牛吃即可;注意,不是入队,此时直接令 \(topend = cow[i].a+cow[i].t\)

2.2 队列中有牛等待,那么 让队首的牛去吃草 ,同时 统计队首的牛的等待时间 (注意不是立马统计第 \(i\) 头牛的等待时间),队首的牛在 \(q.top().a\) 时前来,在 \(topend\) 时吃上草,因此其等待时间为 \(topend-q.top().a\);别忘了在统计后更新 \(topend\),加上 \(q.top().t\),因为当前队首牛也得吃一会;注意,如果当前队首牛吃完的时间 (也就是更新后的 \(topend\)) 仍然小于 \(cow[i].a\),那么我们 重新处理第 \(i\) 头牛的情况,因为可能会需要更改出队信息,即队列中一些看起来在排队的牛实际上已经吃完了;当然,如果更新后的 \(topend\) 大于等于 \(cow[i].a\),那么说明还得等,直接让第 \(i\) 头牛入队即可

注意,处理完所有牛的到达操作后,可能队列里还有牛,因为会有没吃完的情况;此时按一样的方法维护队列,依次让队首牛出队,直到队列里没有牛即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int N, ans;

struct Cow{
    int a;
    int t;
    int id;

    bool operator > (const Cow c) const {
        return c.id < id;
    }
}cow[MAXN];

priority_queue <Cow, vector<Cow>, greater<Cow> > q;

bool cmp(Cow a, Cow b){
    return a.a < b.a;
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d%d", &cow[i].a, &cow[i].t);
        cow[i].id = i;
    }
    sort(cow+1, cow+N+1, cmp);
    // cout << cow[1].id << endl;

    int topend = cow[1].a+cow[1].t;
    for (int i=2; i<=N; i++){
        if (topend <= cow[i].a){
            if (q.empty()){
                topend = cow[i].a+cow[i].t;
            }
            else{
                ans = max(ans, topend-q.top().a);
                topend += q.top().t;
                q.pop();
                if (topend < cow[i].a){
                    i--;
                }
                else{
                    q.push(cow[i]);
                }
            }
        }
        else{
            q.push(cow[i]);
        }   
    }
    while (!q.empty()){
        ans = max(ans, topend-q.top().a);
        topend += q.top().t;
        q.pop();
    }

    printf("%d", ans);
    return 0;
}

2024.7.16 训练记录

BNDSOJ USACO - Grazing Patterns

Grazing Patterns

看到题,首先考虑暴力 \(bfs\);我们将两个起点都存入队列中,当两点移动到同一位置且走过步数之和为 \(25-K\) 时更新答案;实际上,实现起来发现这种做法较为烦琐,因此我们先考虑对题意进行一些简化

实际上,题面中两牛各走出了一条有向路径,且这两条有向路径 终点相同,且 长度相同;考虑对路径进行转化,由于两路径终点相同,我们可以将米尔德里德走出的路径 反向 一下,这样米尔德里德走出的路径起点就为贝茜走出的路径的终点,米尔德里德走出的路径的终点即为 \((5, 5)\);这样两牛的路径就被 合成为一条从 \((1, 1)\) 到 \((5, 5)\) 的路径,又因为合称前两路径长度相同,原相交点实际上也是可以唯一确定的;

因此,我们实际要求的就是从 \((1, 1)\) 走到 \((5, 5)\) 且恰好覆盖了整个地图的路径数量,\(dfs\) 即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
int K, ans=0;
int mp[6][6];
int mv[4][2] = {1, 0, -1, 0, 0, 1, 0, -1};
bool vis[6][6];

void dfs(int x, int y, int step){
    if (x == 5 && y == 5 && step == 25-K){
        ans++;
        return;
    }

    for (int i=0; i<4; i++){
        int nx = x+mv[i][0];
        int ny = y+mv[i][1];

        if (nx<1 || ny<1 || nx>5 || ny>5){
            continue;
        }
        if (mp[nx][ny] == -1 || vis[nx][ny]){
            continue;
        }

        vis[nx][ny] = true;
        dfs(nx, ny, step+1);
        vis[nx][ny] = false;
    }   
}

int main(){
    scanf("%d", &K);

    for (int i=1; i<=K; i++){
        int x, y;
        scanf("%d%d", &x, &y);
        mp[x][y] = -1;
    }

    vis[1][1] = true;
    dfs(1, 1, 1);
    printf("%d", ans);
    return 0;
}

P1884 USACO - Overplanting S

P1884

这道题实际上是扫描线板子,可是我不会呀

首先考虑暴力。有一个很显然的做法,对于一个左上角、右下角坐标分别为 \((lx, ly), (rx, ry)\) 的矩形,枚举 \(x(lx < x \le rx)\) 与 \(y(ry \le y < rx)\),开一个 \(vis\) 数组记录这样的点 \((x, y)\) 是否统计过,如果没有统计过就更新答案并更新 \(vis\) 数组;这种做法很显然会超时

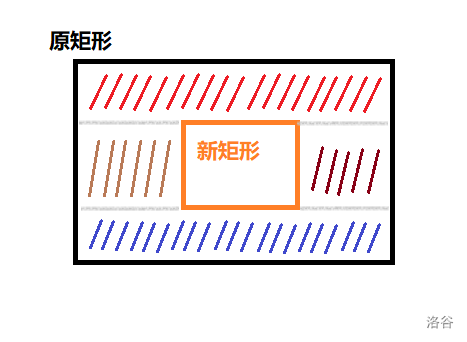
我们注意到暴力做法实际上是通过枚举矩形内每个点来保证不会重复计算面积,这种做法比较直观但很低效;其实问题的关键就在于 如何保证不会重复计算面积,考虑新加入矩形 \((lx, ly), (rx, ry)\),对于之前的任一矩形 \((lx', ly'), (rx', ry')\),新加入的矩形可能会与该矩形产生重叠,那么我们可以考虑把原来的矩形 分割为一些与新矩形不重叠的矩形,这样就解决了重复计算的问题

实现细节上,我们如果直接考虑新矩形整体与原矩形整体的位置关系,会发现有很多情况需要讨论,比较麻烦;其实我们可以直接考虑新矩形 各边 与原矩形对应各边的关系,即 按边分割;举个例子,如果新矩形的下边比原矩形的下边高,说明原矩形底部需要分割出一块小矩形;可以参照下图理解,当新矩形被原矩形完全包含时,我们实际上将原矩形分割成了四块

分割图片

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 2e6+5;

int N, front=0, rear=0;
long long ans;

struct Rec{
    int lx;
    int ly;
    int rx;
    int ry;
}rec[MAXN];

void Cut(Rec rec1, Rec rec2){
    // cout << "use!" << endl;
    if (rec2.ly <= rec1.ry || rec2.ry >= rec1.ly || rec2.lx >= rec1.rx || rec2.rx <= rec1.lx){
        rec[rear].lx = rec1.lx;
        rec[rear].ly = rec1.ly;
        rec[rear].rx = rec1.rx;
        rec[rear].ry = rec1.ry;
        rear++;
        return;
    }   
    if (rec2.ly < rec1.ly){
        rec[rear].lx = rec1.lx;
        rec[rear].ly = rec1.ly;
        rec[rear].rx = rec1.rx;
        rec[rear].ry = rec2.ly;
        rear++;
    }
    if (rec2.ry > rec1.ry){
        rec[rear].lx = rec1.lx;
        rec[rear].ly = rec2.ry;
        rec[rear].rx = rec1.rx;
        rec[rear].ry = rec1.ry;
        rear++;
    }
    if (rec2.lx > rec1.lx){
        rec[rear].lx = rec1.lx;
        rec[rear].ly = min(rec1.ly, rec2.ly);
        rec[rear].rx = rec2.lx;
        rec[rear].ry = max(rec1.ry, rec2.ry);
        rear++;
    }
    if (rec2.rx < rec1.rx){
        rec[rear].lx = rec2.rx;
        rec[rear].ly = min(rec1.ly, rec2.ly);
        rec[rear].rx = rec1.rx;
        rec[rear].ry = max(rec1.ry, rec2.ry);
        rear++;
    }
    return;
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d%d%d%d", &rec[rear].lx, &rec[rear].ly, &rec[rear].rx, &rec[rear].ry);
        int recentrear = rear;
        rear++;

        for (int j=front; j<recentrear; j++){
            Cut(rec[j], rec[recentrear]);
            front++;    
        }
    }

    for (int i=front; i<=rear; i++){
        // cout << "id " << i << ": " << rec[i].lx << " " << rec[i].ly << " " << rec[i].rx << " " << rec[i].ry << endl;
        ans += 1ll*(rec[i].rx-rec[i].lx)*(rec[i].ly-rec[i].ry); 
    }

    printf("%lld", ans);
    return 0;
}

P4087 USACO - Milk Measurement S

P4087

记产量最大的牛的个数 \(cnt1\),我们发现,如果照片需要被调整,要么是 \(cnt1\) 发生变化,要么就是具体的牛有变化;按照这个思路,我们先具体分析一下如果照片需要被改变,可能需要满足什么条件

具体的,我们考虑分情况讨论:记 \(recentmilk\) 为 测量前 的最大产量,\(recentcnt\) 为测量前最大产量的个数,\(maxmilk\) 为 测量后 的最大产量,\(maxcnt\) 为测量后最大产量的个数


  1. 测量后最大产量不变 (\(recentmilk = maxmilk\))

1.1 测量后 最大个数发生变化,即此时 \(recentcnt \ne maxcnt\),那么显然照片要发生变化

1.2 测量后最大个数不变化,即此时 \(recentcnt = maxcnt\) ,我们反证:如果照片还会发生改动,那么只能是测量后具体的牛发生了变化,即有一头牛上来有一头牛下去,但一次测量只能改变一头牛,因此这种情况不成立


  1. 测量后最大产量变化 (\(recentmilk \ne maxmilk\))

2.1 测量后 最大个数发生变化,显然照片也要发生变化

2.2 如果最大个数不变:

2.2.1 一头测量前产量最大的牛经过测量后产量发生变化。再分产量变大或变小两种情况讨论

2.2.1.1 其产量变大。此时最大个数会发生变化 (变成 \(1\)),又由于最大个数不变,那么原本的最大个数就是 \(1\),这样对照片不会产生影响

2.2.1.2 其产量变小。如果其变小后仍然产量最大,此时又由于最大个数不变,那就说明原来的最大个数是 \(1\),现在还是 \(1\),此时对照片不产生影响。另一种情况,如果其变小后不再是产量最大的牛,说明变小后有另一些牛的产量比它大了,那么照片需要变化

2.2.2 一头测量前产量不是最大的牛经过测量后产量变为最大。此时最大个数变为 \(1\),那么原本的最大个数也为 \(1\),又因为此时具体的牛发生变化,所以照片需要变化


我们对上面的讨论进行总结,如果照片会发生变化,可能有如下情况

  1. 测量后 最大个数发生变化,即 \(recentcnt \ne maxcnt\)
  2. 测量后最大产量发生变化,而该次变化的牛为测量前产量最大的牛,其产量变小,变化后不再是产量最大的牛;又因为如果其产量变大,一定是产量最大的牛,所以该条也可以表述为测量后最大产量发生变化,且该次变化的牛为测量其产量最大的牛,其变化后不再是产量最大的牛;进一步的,如果该次变化的牛不是测量前产量最大的牛,原本产量最大的牛最终也不会是产量最大的牛;因此可以进一步表述为 测量后最大产量发生变化,且变化后原本最大产量的牛不再是现在最大产量的牛
  3. 测量后最大产量发生变化,且为测量前产量非最大的牛发生变化

现在我们就解决了何时照片会变化的问题,全程只需要维护 \(recentmilk, maxmilk, recentcnt, maxcnt\) 与支持给定奶牛查询奶牛当前产奶量、给定奶量查询当前产奶量为该奶量的奶牛有多少个的数据结构;容易发现这些数据结构只需要支持单点改单点查,因此我们没必要开线段树,只开 \(map\) 即可

我们枚举每一次测量,按题意对两个 \(map\) 进行维护,维护前进行 \(recentmilk = maxmilk, recentcnt = maxcnt\) 存储上一次的信息,维护后更新 \(maxmilk\) 与 \(maxcnt\),再记录本次更改是否更改的是最大牛,更改后原本最大牛是否还是最大牛,按照总结出的条件进行维护即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5, INF = 2e9;

int N, G, ans;

struct Measure{
    int day;
    int id;
    long long c;
}m[MAXN];

bool cmp(Measure a, Measure b){
    return a.day < b.day;
}

map <int, long long> milk;
map <int, int> cnt;

int main(){
    scanf("%d%d", &N, &G);

    for (int i=1; i<=N; i++){
        scanf("%d%d%lld", &m[i].day, &m[i].id, &m[i].c);
    }
    sort(m+1, m+N+1, cmp);

    long long maxmilk=0, recentmilk=0;
    int maxcnt=INF, recentcnt=0;
    bool flagbefore = false, flagafter = false;
    cnt[0] = INF;

    for (int i=1; i<=N; i++){
        if (milk[m[i].id] == maxmilk){
            flagbefore = true;
        }
        else{
            flagbefore = false;
        }
        cnt[milk[m[i].id]]--;
        if (cnt[milk[m[i].id]] == 0){
            cnt.erase(milk[m[i].id]);
        }
        milk[m[i].id]+=m[i].c;
        cnt[milk[m[i].id]]++;

        recentmilk = maxmilk;
        recentcnt = maxcnt;
        auto it = cnt.end();
        it--;
        maxmilk = (*it).first;
        maxcnt = (*it).second;
        if (milk[m[i].id] == maxmilk){
            flagafter = true;
        }
        else{
            flagafter = false;
        }

        if (maxcnt != recentcnt){
            ans++;
        }
        else if ((flagbefore == false || flagafter == false) && (maxmilk != recentmilk)){
            ans++;
        }
    }
    printf("%d", ans);
    return 0;
}

P4089 USACO - The Bovine Shuffle

P4089

我们观察到,如果 \(i, a[i], a[a[i]], ...\) 形成一个环,则在这个环里的奶牛只会在这个环里按顺序来回跳;又因为初始时这个环上的每个点都有奶牛,则 任意时刻这个环上也都有奶牛。

因此,我们将每个 \(i\) 对 \(a[i]\) 连边,拓扑排序 判环即可,最终拓扑排序删不掉的点的个数就是答案

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int N, ans;
int a[MAXN], in[MAXN];

vector <int> G[MAXN];

void TopoSort(){
    queue <int> S;

    for (int i=1; i<=N; i++){
        if (in[i] == 0){
            S.push(i);
        }   
    }

    while (!S.empty()){
        int recent = S.front();
        S.pop();
        ans++;

        for (int i=0; i<G[recent].size(); i++){
            in[G[recent][i]]--;
            if (in[G[recent][i]] == 0){
                S.push(G[recent][i]);
            }
        }
    }
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d", &a[i]);
        G[i].push_back(a[i]);
        in[a[i]]++;
    }

    TopoSort();
    printf("%d", N-ans);
    return 0;
}

P4378 Out Of Sorts S

P4378

本质上,一次循环会消掉每个位置上的一个逆序对;因此,逆序对最多的一个位置的逆序对个数 \(+1\) 即为答案;

我们感性理解,将数列从小到大排序,认为每个元素前移的距离反映了其原位置上逆序对的数量;但是这么做有问题,每个元素前移的距离并不能真正代表其原位置上逆序对数量,举个例子,设原数列为 \(3, 2, 1\),排序后为 \(1, 2, 3\),元素 \(2\) 前移的距离为 \(0\),但实际上其原位置上有一个逆序对 \((3, 2)\);

问题出在哪呢?我们发现,\(2\) 前面有一个 \(1\),顶掉了一个前移的距离,这说明若一个元素 \(a_i\) 后有比它的值还小的元素 \(a_j (a_j < a_i)\),排序后 \(a_j\) 会变到 \(a_i\) 前面影响原 \(a_i\) 位置上的逆序对个数统计;但又由于我们 只关注逆序对数最大的位置,由于 \(a_i > a_j\),\(a_i\) 及以前所有大于等于它的元素都会大于 \(a_j\),所以 \(a_j\) 位置上的逆序对个数严格大于 \(a_i\),这样我们只关注 \(a_j\) 即可,\(a_i\) 位置上的逆序对数量统计差异对答案 没有影响

因此,我们将原序列排序,统计元素的 最大移动距离,最后 \(+1\) 即可 (为什么 \(+1\)? 因为最终冒泡排序完成后还要再扫一遍确定已经不需要再来一轮)

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int N, ans;

struct Node{
    int val;
    int pos;
}num[MAXN];

bool cmp(Node a, Node b){
    if (a.val == b.val){
        return a.pos < b.pos;
    }
    return a.val < b.val;
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d", &num[i].val);
        num[i].pos = i;
    }
    sort(num+1, num+N+1, cmp);

    for (int i=1; i<=N; i++){
        ans = max(ans, num[i].pos-i);
    }
    printf("%d", ans+1);
    return 0;
}

P4380 USACO - Multiplayer Moo S

P4380

第一问简单 \(dfs\) 即可,关键在于第二问

首先有一个思路,直接枚举每个相邻且颜色不同的方格,以这两个颜色为基准颜色,暴力进行 \(dfs\) 统计答案;这样肯定可以写,但比较麻烦,这里有一个更好的思路

在进行第一遍 \(dfs\) 时,我们实际上已经能够得出每个连通块的基本信息 (如大小,颜色),没必要在第二遍再 \(dfs\) 一次;因此,第一遍时我们记录下每个连通块的大小 \(siz\) 与颜色 \(col\),开结构体存储,同时开二维数组 \(belong[i][j]\) 表示 \((i, j)\) 格属于哪个连通块;求第二问时,我们仍然枚举每个方格,但这次是为了在相邻的连通块间 连边

连好后,我们得到了一个无向连通图,希望求出相邻的、颜色为两个颜色之一的连通块的大小之和;由于连通块的性质,图上直接相连的两连通块颜色必然不同,因此枚举每个连通块及颜色,\(dfs\) 即可

实现细节上,首先,连边时记得开 \(vis\) 数组记录相邻的连通块是否已经连过边了,不要重复连边;其次,可以在连边时同时记录每个连通块相邻的连通块有什么颜色 (即 \(dfs\) 时该连通块除自身颜色的第二个颜色都有什么选择),方便 \(dfs\);每次枚举连通块,直接把该连通块所有的颜色可能 \(dfs\) 完,以后再遇到该连通块直接 \(continue\) 即可

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 505, MAXL = 7e4+5;

int N, cnt, recentsiz, ans1, ans2;
int mv[4][2] = {0, 1, 0, -1, 1, 0, -1, 0};
int mp[MAXN][MAXN], belong[MAXN][MAXN];
bool vis[MAXN][MAXN];

map <int, bool> visedge[MAXL];

struct Node{
    int siz;
    int col;
}node[MAXL];

vector <int> G[MAXL];

void dfs(int x, int y, int tp){
    belong[x][y] = cnt;
    node[cnt].siz++;

    for (int i=0; i<4; i++){
        int nx = x+mv[i][0];
        int ny = y+mv[i][1];

        if (nx<1 || ny<1 || nx>N || ny>N){
            continue;
        }
        if (mp[nx][ny] != tp || vis[nx][ny] == true){
            continue;
        }

        vis[nx][ny] = true;
        dfs(nx, ny, tp);
    }
}

vector <int> colors[MAXL];
map <int, bool> vis_2[MAXL];

void dfs_2(int nod, int col1, int col2){
    recentsiz += node[nod].siz;
    for (int i=0; i<G[nod].size(); i++){
        if (node[G[nod][i]].col == col1 && vis_2[G[nod][i]][col2] == false){
            vis_2[G[nod][i]][col2] = true;
            dfs_2(G[nod][i], col1, col2);       
        }
        else if (node[G[nod][i]].col == col2 && vis_2[G[nod][i]][col1] == false){
            vis_2[G[nod][i]][col1] = true;
            dfs_2(G[nod][i], col1, col2);   
        }
    }   
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        for (int j=1; j<=N; j++){
            scanf("%d", &mp[i][j]);
        }
    }

    for (int i=1; i<=N; i++){
        for (int j=1; j<=N; j++){
            if (vis[i][j] == false){
                cnt++;
                node[cnt].col = mp[i][j];
                vis[i][j] = true;
                dfs(i, j, mp[i][j]);
            }   
        }
    }

    for (int i=1; i<=cnt; i++){
        ans1 = max(ans1, node[i].siz);
    }

    int i, j, k;
    for (i=1; i<=N; i++){
        for (j=1; j<=N; j++){
            for (k=0; k<4; k++){
                int nx = i+mv[k][0];
                int ny = j+mv[k][1];

                if (nx<1 || ny<1 || nx>N || ny>N){
                    continue;
                }
                if (visedge[belong[nx][ny]][belong[i][j]] == false){
                    visedge[belong[nx][ny]][belong[i][j]] = true;
                    visedge[belong[i][j]][belong[nx][ny]] = true;               

                    G[belong[nx][ny]].push_back(belong[i][j]);
                    G[belong[i][j]].push_back(belong[nx][ny]);
                    colors[belong[nx][ny]].push_back(node[belong[i][j]].col);
                    colors[belong[i][j]].push_back(node[belong[nx][ny]].col);
                }
            }
        }
    }

    for (int i=1; i<=cnt; i++){
        for (int j=0; j<colors[i].size(); j++){
            if (vis_2[i][colors[i][j]] == false){
                vis_2[i][colors[i][j]] = true;
                recentsiz = 0;
                dfs_2(i, node[i].col, colors[i][j]);
                ans2 = max(ans2, recentsiz);
            }   
        }
    }

    printf("%d\n%d", ans1, ans2);
    return 0;
}

2024.7.15 训练记录

P3034 USACO - Cow Photography

P3034

看到题,第一眼考虑将五次拍照的序列经过一些方法组合得到原序列,思考后发现不好做;我们考虑不变量,每次有一个元素随意移动到新的位置,对于序列元素的绝对位置其实不怎么好刻画,因为可能会产生整体偏移;但仔细一想,这一操作对序列元素的 相对位置 影响不大,因此我们考虑序列元素的相对位置关系

思路已经有了,问题来了,怎么确定要考察的两个元素不是在该次移动的元素呢?题目其实给了一个很重要的条件 —— 一个元素最多只会移动一次,因此我们从整体考虑,对于序列中的两元素 \(a_i, a_j (i<j)\),会对其相对位置造成影响的移动 最多只会出现 \(2\) 次,即将 \(a_j\) 挪到 \(a_i\) 前或将 \(a_i\) 挪到 \(a_j\) 后,题目刚好给了 \(5\) 次拍照结果,因此我们考察元素 \(a_i, a_j\),如果有 \(3\) 次拍照结果中都有 \(i<j\),那么在原序列中就有 \(i<j\)

由此知道了原序列中任意两元素的相对位置关系,现在我们希望求出原序列,正好发现 \(sort\) 的 \(cmp\) 函数可以完美切合这个问题,因此直接任取一次拍照结果 \(sort\) 一遍,排序结果就是原序列

实现细节上,我们要记录在第 \(i(1\le i \le 5)\) 次拍照中元素 \(a_i (0 \le a_i \le 1000000000)\) 的位置,值域很大,因此使用 \(map\) 记录,开 \(O2\) 即可水过;事实上由于本题中没有查询,使用 \(umap\) 会更快,实测不开 \(O2\) 最慢点约 \(700ms\),可过

时间复杂度 \(O(nlogn)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 2e4+5;

int N;
int A[6][MAXN];
int ans[MAXN];

unordered_map <int, unordered_map <int, int> > pos;

bool cmp(int a, int b){
    int cnt=0;
    for (int i=1; i<=5; i++){
        if (pos[i][a] < pos[i][b]){
            cnt++;
        }
    }
    if (cnt >= 3){
        return true;
    }
    return false;
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=5; i++){
        for (int j=1; j<=N; j++){
            scanf("%d", &A[i][j]);
            pos[i][A[i][j]] = j;
        }
    }
    for (int i=1; i<=N; i++){
        ans[i] = A[1][i];
    }

    sort(ans+1, ans+N+1, cmp);

    for (int i=1; i<=N; i++){
        printf("%d\n", ans[i]);
    }
    return 0;
}

P4188 USACO - Lifeguards S

P4188

我们考虑先求出所有区间覆盖的 时间点,再减去单个区间中与其他区间 不重叠 时间点的数量最小值;注意这里是时间点,所以如果给定区间 \(l, r (l \le r)\),实际上覆盖的时间点有 \(r-l\) 个而非 \(r-l+1\) 个

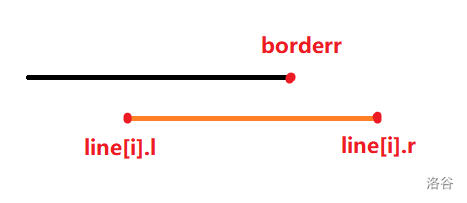
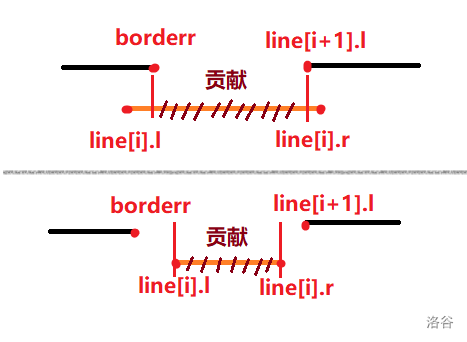
先考虑如何求出所有区间覆盖的时间点。首先必不可少的肯定是先给区间按照左端点 \(sort\) 一遍;接下来使用类似双指针的思想,考虑新加入线段 \(line[i]\),参照下图,我们定义 \(borderr\) 表示新加入线段前 己经加入的线段能够覆盖的最大时间点,\(line[i].l\) 表示目前区间的左端时间点,\(line[i].r\) 表示目前区间的右端时间点

定义图片

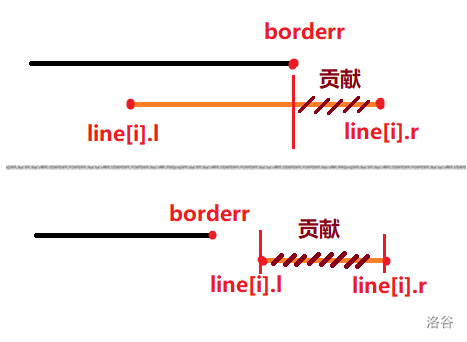
容易发现,如果 \(line[i].r \le borderr\),那么当前线段没有真正产生贡献,跳过即可;当 \(line[i].r > borderr\) 时,我们希望求出当前线段 左侧不与先前加入线段重叠的最大时间点,设为 \(recentl\),这样该线段的贡献即为 \(line[i].r - recentl\),如下图为两种不同情况,易得 \(recentl = max(borderr, line[i].l)\)

总覆盖图片

因此枚举每个区间统计即可,别忘了每次统计后还要更新 \(borderr\),直接令 \(borderr = line[i].r\) 即可,这样我们就解决了总贡献

接下来考虑如何求出单个区间的贡献。设当前区间为 \(line[i]\),首先仍然要特判 \(line[i].r \le borderr\),这说明有区间被完全包含,此时 \(break\) 后直接输出总贡献即可;最坏情况下,单个区间 \(line[i]\) 可能会与之前的区间产生重叠,也会与后一个区间 \(line[i+1]\) 产生重叠,我们考虑 \(line[i].l\) 与 \(borderr\)、\(line[i].r\) 与 \(line[i+1].l\) 的关系,左端点处最大无重叠时间点即为 \(max(line[i].l, borderr)\),右端点最大无重叠时间点即为 \(min(line[i].r, line[i+1].l)\),可以结合下图理解

单个区间贡献图片

因此我们统计处最小的单个区间贡献,最终用总贡献减去即可得到最终答案;实现时注意该贡献可能为 负数,此时可以特判为 \(0\) 并直接 \(break\);同时,和统计总贡献时相同,也别忘了更新 \(borderr\) 即 \(borderr = line[i].r\)

时间复杂度 \(O(nlogn)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int N;
long long sum, mcover=1e9;

struct Line{
    int l;
    int r;
}line[MAXN];

bool cmp(Line a, Line b){
    if (a.l == b.l){
        return a.r < b.r;
    }
    return a.l < b.l;
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d%d", &line[i].l, &line[i].r);
    }
    sort(line+1, line+N+1, cmp);

    int borderr = 0;
    for (int i=1; i<=N; i++){
        if (line[i].r > borderr){
            int recentl = max(line[i].l, borderr);
            sum += line[i].r-recentl;
            borderr = line[i].r;
        }   
    }

    borderr = 0;
    line[N+1].l = line[N].r;
    for (int i=1; i<=N; i++){
        if (line[i].r <= borderr){
            mcover = 0;
        }
        else{
            long long cover = min(line[i+1].l, line[i].r)-max(line[i].l, borderr);
            mcover = min(mcover, cover);
            borderr = line[i].r;
        }

        if (mcover <= 0){
            mcover = 0;
            break;
        }   
    }

    printf("%lld", sum-mcover);
    return 0;
}

P4181 USACO - Rental Service S

P4181

每个奶牛有两种分配方式,一种是将奶牛租出去,一种是卖出该奶牛生产的奶;首先注意到租奶牛这一方式对具体租哪一只奶牛没有限制,因此易得贪心,即 优先租产奶量小的奶牛,同时 优先租给价格最高的农场主;同理,卖奶时也 优先卖给价格最高的商店

因此,我们将商店按照价格 从大到小排序、将租奶牛的农场主按照租用价格 从大到小排序;我们注意到将所有奶牛排序后,必然有从头连续一部分选择租出去,剩下一部分选择卖出去,因此考虑 枚举断点 \(i\) ,钦定将第 \(1\) 到第 \(i\) 头奶牛的奶卖出去,第 \(i+1\) 到第 \(N\) 头奶牛租出去;所以,我们也要对奶牛按照产奶量 从大到小排序

这样,我们将总贡献分为两部分,一部分来自租出奶牛;这一部分很好维护,直接上 前缀和 即可,对排序后的 \(r[i]\) 数组,定义 \(sum[i]\) 为其前缀和数组,表示租出 \(i\) 头牛能得到的钱

对于卖奶牛奶的部分,虽然卖出奶的总和也可以用前缀和维护,但如果每次都从第 \(i\) 个商店向后循环处理是否能卖出奶会超时;由于我们知道相邻两次卖奶总和的 增量 (设当前奶牛为 \(i\),这个增量实际上就是 \(c[i]\)),因此可以 直接考虑其对答案的影响,记录下上一次卖完后所得所有的钱 \(sell\),当前卖到的商店位置 \(cnt\),直接进行处理即可;这里有个技巧,我们可以单独开一个变量记录当前商店中已有的牛奶 \(storemilk\),这样省去了直接改动商店原本信息的麻烦

具体的,设当前要卖出的牛奶 (增量) 为 \(milk=c[i]\),第 \(i\) 个的商店的容量为 \(store[i].q\) (实际剩余容量为 \(store[i].q-storemilk\)) 、价格为 \(store[i].p\),分情况讨论;

  1. 当商店剩余容量不足 \(milk\) 时
    • 用 \(store[i].q-storemilk\) 更新 \(sell\)
  2. 更新当前要卖出的牛奶数量 \(milk\)
  3. 收回 \(storemilk\),将其设为 \(0\)
  4. 别忘了进行 \(cnt+1\)
  5. 当商店剩余容量够 \(milk\) 时
  6. 用 \(milk\) 更新 \(sell\) (特别注意!这里不是 \(storemilk+milk\))
  7. 更新 \(storemilk\) (因为这里 \(store[i].q\) 的变化实际上直接体现在了 \(storemilk\) 的变化上)
  8. 跳出循环即可,因为已经卖光了

最终统计出当前的总价值,加上租出的价值,与最终答案 \(ans\) 比较,这里如果 当前总价值 $ \le ans$,其实 可以直接 \(break\) ,因为容易证明价值变化分界点唯一

代码

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int N, M, R;
int c[MAXN], r[MAXN];
long long sumr[MAXN];
long long ans = 0;

struct Store{
    int p;
    int q;
}store[MAXN];

bool cmp(int a, int b){
    return a>b;
}
bool cmp_store(Store a, Store b){
    if (a.p == b.p){
        return a.q > b.q;
    }
    return a.p > b.p;
}

int main(){
    scanf("%d%d%d", &N, &M, &R);

    for (int i=1; i<=N; i++){
        scanf("%d", &c[i]);
    }
    sort(c+1, c+N+1, cmp);
    for (int i=1; i<=M; i++){
        scanf("%d%d", &store[i].q, &store[i].p);
    }
    sort(store+1, store+M+1, cmp_store);
    for (int i=1; i<=R; i++){
        scanf("%d", &r[i]);
    }
    sort(r+1, r+R+1, cmp);

    for (int i=1; i<=R; i++){
        sumr[i] = sumr[i-1]+r[i];   
    }

    long long storemilk=0, cnt=1;
    long long sell=0, rent=0;

    for (int i=0; i<=N; i++){
        long long milk = c[i];
        while (cnt<=M){
            if (milk+storemilk >= store[cnt].q){
                milk = milk+storemilk-store[cnt].q;
                sell += 1ll*(store[cnt].q-storemilk)*store[cnt].p;
                storemilk = 0;
                cnt++;
            }   
            else{
                sell += 1ll*milk*store[cnt].p;
                storemilk = milk+storemilk;
                break;
            }
        }   
        rent = sumr[min(N-i, R)];
        if (rent+sell > ans){
            ans = rent+sell;
        }
        else{
            break;
        }
    }

    printf("%lld", ans);
    return 0;
}

P4265 - USACO Snow Boots S

P4265

考虑 \(DP\);设 \(dp[i]\) 表示到第 \(i\) 格所穿的靴子编号 (也就是丢弃了 \(dp[i]-1\) 双靴子),考虑转移,显然到第 \(i\) 格只能由前面的格子转移而来,因此枚举 \(j (1 \le j < i)\);因为我们要么直接穿着在第 \(j\) 格的靴子走到第 \(i\) 格,要么在第 \(j\) 格脱下一些靴子再走到第 \(i\) 格,所以再枚举 \(k (dp[j] \le k \le B)\),表示到达第 \(i\) 格时所穿的靴子

我们想从第 \(j\) 格穿着第 \(k\) 个靴子走到第 \(i\) 格,需要: - 第 \(k\) 个靴子能够走在第 \(j\) 格的雪上 - 第 \(k\) 个靴子能够走在第 \(i\) 格的雪上 - 第 \(k\) 个靴子能走的距离至少是 \(i\) 到 \(j\) 的距离

转移方程很简单,就是 \(dp[i] = min(dp[i], k)\),答案即为 \(dp[N]-1\),注意不要忘记 \(-1\)

初始情况为 \(dp[1] = 0\),因为一开始不穿靴子,另外由于需要求最小值,别忘了在最开始 \(memset\) 一下

时间复杂度 \(O(N^2B)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 305;

int N, B;
int h[MAXN], s[MAXN], d[MAXN];
int dp[MAXN];

int main(){
    scanf("%d%d", &N, &B);

    for (int i=1; i<=N; i++){
        scanf("%d", &h[i]);
    }
    for (int i=1; i<=B; i++){
        scanf("%d%d", &s[i], &d[i]);
    }

    memset(dp, 0x3f, sizeof(dp));
    dp[1] = 0;
    for (int i=2; i<=N; i++){
        for (int j=1; j<i; j++){
            for (int k=dp[j]; k<=B; k++){
                if (s[k] >= h[i] && s[k] >= h[j] && d[k]>=i-j){
                    dp[i] = min(dp[i], k);
                }
            }   
        }
    }

    printf("%d", dp[N]-1);
    return 0;
}

P4264 USACO - Teleportation S

P4264

不会。咕咕咕。

区间DP基础 做题记录

BNDSOJ DP-3-2 能量项链

BNDSOJ DP-3-2 能量项链

发现给定珠子序列为长度为 \(n\) 的一个环,那么显然需要破环成链;具体的,将整个序列复制一份接到原序列末尾,区间 DP 已经保证了统计的区间长度不会超过 \(n\),统计答案时枚举起点取最大值即可

不妨依据题意设 \(dp[i][j]\) 表示将区间 \([i, j]\) 间的珠子合并所能得到的最大能量;设第 \(i\) 颗珠子上的值为 \(v[i]\),考虑转移,则枚举 \(k(i<k<j)\) 作为 "分割点",\(dp[i][j] = max(dp[i][k]+dp[k][j]+v[i] \times v[k] \times v[j])\),即先分别统计将 \([i, k]\) 与 \([k, j]\) 合并能获得的价值的最大值,最终加上本次合并获得的价值即 \(v[i] \times v[k] \times v[j]\)

时间复杂度 \(O(n^3)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 205;

int n, ans=0;
int num[MAXN];
int dp[MAXN][MAXN];

int main(){
    scanf("%d", &n);

    for (int i=1; i<=n; i++){
        scanf("%d", &num[i]);
        num[n+i] = num[i];
    }

    for (int l=1; l<=n; l++){
        for (int i=1; i<=2*n-l; i++){
            int lhs=i, rhs=i+l;
            for (int k=lhs+1; k<rhs; k++){
                dp[lhs][rhs] = max(dp[lhs][rhs], dp[lhs][k]+dp[k][rhs]+num[lhs]*num[k]*num[rhs]);
            }
        }
    }

    for (int i=1; i<=n; i++){
        ans = max(ans, dp[i][i+n]);
    }
    printf("%d", ans);
    return 0;
}

BNDSOJ DP-3-3 乘法游戏

BNDSOJ DP-3-3 乘法游戏

发现题目中要求的并不是合并牌而是拿走牌,因此满足区间 DP 的性质,考虑设 \(dp[i][j]\) 表示将区间 \([i, j]\) 内的数合并能得到的最大价值,设第 \(i\) 个数为 \(v[i]\);考虑转移,枚举转移点 \(k(i<k<j)\),则 \(dp[i][j] = max(dp[i][k]+dp[k][j]+v[i] \times v[k] \times v[j])\);

初始状态为 \(dp[i][i]=0(1 \le i \le n)\) 与 \(dp[i][i+1]=0(1 \le i < n)\),因为无法合并长度小于 \(3\) 的区间;题目中要求不能选取第 \(1\) 个与第 \(n\) 个数,但区间 DP 的转移点一定满足在 \((1, n)\) 范围内,不会越出,因此不需要特殊考虑

答案即为 \(dp[1][n]\)

时间复杂度 \(O(n^3)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 205;

int n;
int num[MAXN];
int dp[MAXN][MAXN];

int main(){
    scanf("%d", &n);
    memset(dp, 0x3f, sizeof(dp));

    for (int i=1; i<=n; i++){
        scanf("%d", &num[i]);
        dp[i][i] = 0;
    }
    for (int i=1; i<n; i++){
        dp[i][i+1] = 0;
    }

    for (int l=1; l<=n; l++){
        for (int i=1; i<=n-l+1; i++){
            int lhs=i, rhs=i+l-1;
            for (int k=lhs+1; k<rhs; k++){
                dp[lhs][rhs] = min(dp[lhs][rhs], dp[lhs][k]+dp[k][rhs]+num[lhs]*num[k]*num[rhs]);
            }
        }
    }

    printf("%d", dp[1][n]);
    return 0;
}

BNDSOJ DP-3-4 石子合并

BNDSOJ DP-3-4 石子合并

由于最大值与最小值本质相同,以下只考虑最大值

首先注意到石子排成了一个环,因此还是考虑破环成链,将原序列复制一份接在原序列的后面;设第 \(i\) 堆石子价值为 \(v[i]\),合并区间 \([i, j]\) 的石子的价值为 \(val(i, j)\),考虑设 \(dp[i][j]\) 表示将区间 \([i, j]\) 中的石子合并能获取的最大价值,仍然枚举 \(k(i \le k<j)\) 作为转移点,\(dp[i][j] = max(dp[i][k]+dp[k+1][j]+val(i, j))\);由于一次合并获得的是两堆石子的价值之和,合并一次区间就获得一次区间内所有石子的价值之和,因此 \(val(i, j) = \sum_{k=i}^{j} v[k]\),可以使用前缀和维护

对于初始状态,由于一次合并最少合并相邻的两堆石子,因此 \(dp[i][i]=0 (1 \le i \le n)\)

时间复杂度 \(O(n^3)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 405;

int n, ans=0, ans2=2147483647;
int num[MAXN], sum[MAXN];
int dp[MAXN][MAXN], dp2[MAXN][MAXN];

int main(){
    scanf("%d", &n);
    memset(dp2, 0x3f, sizeof(dp2));

    for (int i=1; i<=n; i++){
        scanf("%d", &num[i]);
        num[n+i] = num[i];
    }
    for (int i=1; i<=2*n; i++){
        sum[i] = sum[i-1]+num[i];
        dp2[i][i] = 0;
    }

    for (int l=2; l<=n; l++){
        for (int i=1; i<=2*n-l-1; i++){
            int lhs=i, rhs=i+l-1;
            for (int k=lhs; k<rhs; k++){
                dp[lhs][rhs] = max(dp[lhs][rhs], dp[lhs][k]+dp[k+1][rhs]+sum[rhs]-sum[lhs-1]);
                dp2[lhs][rhs] = min(dp2[lhs][rhs], dp2[lhs][k]+dp2[k+1][rhs]+sum[rhs]-sum[lhs-1]);  
            }
        }   
    }

    for (int i=1; i<=n-1; i++){
        ans = max(ans, dp[i][i+n-1]);
        ans2 = min(ans2, dp2[i][i+n-1]);
    }
    printf("%d\n%d", ans2, ans);
    return 0;
}

BNDSOJ DP-3-5 括号配对

BNDSOJ DP-3-5 括号配对

令第 \(i\) 个字符为 \(s[i]\),设 \(dp[i][j]\) 表示将区间 \([i, j]\) 变为 \(GBE\) 的最少操作数,仍然考虑枚举 \(k(i \le k<j)\),由于区间中的同一位置只需要修改一次,因此 \(dp[i][j]=min(dp[i][k]+dp[k+1][j])\);注意第二个区间的左端点为 \(k+1\),枚举 \(k\) 的范围包含 \(i\);

但如果这么转移,实际上忽略了 "如果 \(A\) 是 \(GBE\),那么 \([A]\) 与 \((A)\) 也是 \(GBE\)" 的条件,因此可以很容易举出反例,比如输入 [(],会输出 3,实际上应该输出 1;那么如何加上这一条件?当我们合并区间 \([i, j]\) 时,如果 \(s[i]\) 与 \(s[j]\) 构成了 [] 或者 (),就只需要考虑合并 \([i+1, j-1]\),因此在转移后判断 \(s[i]\) 与 \(s[j]\) 是否构成 [] 与 (),如果构成就加上 $dp[i][j] = min(dp[i][j], dp[i+1][j-1]) $ 即可

初始条件为 \(dp[i][i] = 1 (1 \le i \le n)\),答案即为 \(dp[i][n]\)

时间复杂度 \(O(n^3)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 505, MAXINT = 2e9;

string s;
int dp[MAXN][MAXN];

int main(){
    cin >> s;

    for (int i=0; i<s.size(); i++){
        dp[i+1][i+1] = 1;
    }

    for (int l=2; l<=s.size(); l++){
        for (int i=1; i<=s.size()-l+1; i++){
            int lhs=i, rhs=i+l-1;
            dp[lhs][rhs] = MAXINT;
            for (int k=lhs; k<rhs; k++){
                dp[lhs][rhs] = min(dp[lhs][rhs], dp[lhs][k]+dp[k+1][rhs]);
            }

            if ((s[lhs-1] == '(' && s[rhs-1] == ')') || (s[lhs-1] == '[' && s[rhs-1] == ']')){
                dp[lhs][rhs] = min(dp[lhs][rhs], dp[lhs+1][rhs-1]);
            }
        }   
    }

    printf("%d", dp[1][s.size()]);
    return 0;
}

BNDSOJ DP-4-2 凸多边形划分

BNDSOJ DP-4-2 凸多边形划分

我们考虑设 \(dp[i][j]\) 表示将以 \(i\) 为开头,\(j\) 为结尾的多边形分割后可以获得的最大价值;注意到每个边都肯定会用且仅用一次,因此我们枚举分割点 \(k (i<k<j)\),使得 \(i, j, k\) 构成一个三角形,再套路地统计 \(dp[i][k]\) 与 \(dp[k][j]\) 即可;转移方程即为 \(dp[i][j] = min(dp[i][j], dp[i][k]+dp[k][j]+num[i] \times num[k] \times num[j])\)

值域较大,\(long long\) 存不下,记得开 \(int128\)

时间复杂度 \(O(n^3)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 55;
const __int128 INF = 1e35;

__int128 read128(){
    __int128 x=0;bool f=1;char ch=getchar();
    while (ch<'0'||ch>'9'){if(ch=='-') f=!f;ch=getchar();}
    while (ch>='0'&&ch<='9'){x=(x<<1)+(x<<3)+(ch^48);ch=getchar();}
    x=(f?x:-x);return x;
}
inline void put128(__int128 x){
    if (x<0) putchar('-'), x=-x;
    if (x>9) put128(x/10);
    putchar(x%10+'0'); return;
}

int N;
__int128 num[MAXN];
__int128 dp[MAXN][MAXN];

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        num[i]=read128();
    }

    for (int len=3; len<=N; len++){
        for (int i=1; i<=N-len+1; i++){
            int lhs=i, rhs=i+len-1;
            dp[lhs][rhs] = INF;
            for (int k=lhs+1; k<rhs; k++){
                dp[lhs][rhs] = min(dp[lhs][rhs], dp[lhs][k]+dp[k][rhs]+num[lhs]*num[k]*num[rhs]);
            }
        }
    }

    put128(dp[1][N]);
    return 0;
}

DP基础 做题记录

BNDSOJ DP-1-1 最长不下降子序列

BNDSOJ DP-1-1 最长不下降子序列

对于序列 \(a_i\),设 \(f[i]\) 表示以 \(i\) 结尾的最长不下降子序列长度,循环枚举 \(j\) \((1 \leq j \leq i-1)\),若 \(a_j \leq a_i\),则可以从 \(f[j]\) 转移至 \(f[i]\),具体来说 \(f[i] = f[j]+1\)

时间复杂度 \(O(n^2)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 10005;

int n, ans=0;
int num[MAXN], f[MAXN];

int main(){
    scanf("%d", &n);

    for (int i=1; i<=n; i++){
        scanf("%d", &num[i]);
    }
    for (int i=1; i<=n; i++){
        f[i] = 1;
    }

    for (int i=1; i<=n; i++){
        for (int j=1; j<i; j++){
            if (num[j] <= num[i]){
                f[i] = max(f[i], f[j]+1);
            }
        }
    }

    for (int i=1; i<=n; i++){
        ans = max(ans, f[i]);
    }

    printf("%d", ans);
    return 0;
}

BNDSOJ DP-1-2 友好城市

BNDSOJ DP-1-2 友好城市

使用结构体记录对应的友好城市,首先按照河岸一边城市的横坐标 \(a_i\) 进行排序

设两对友好城市横坐标为 \((a_1, b_1)\) 与 \((a_2, b_2)\),若希望使得两对友好城市不 "相交",当且仅当 (\(a_1 \leq a_2\) 且 $ b_1 \leq b_2\() 或 (\)a_1 \geq a_2$ 且 \(b_1 \geq b_2\))

因此,希望排序后河岸另一边城市的横坐标 \(b_i\) 单调不降,问题即转化为对序列 \(b_i\) 求最长不下降子序列

时间复杂度 \(O(n^2)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 5005;

int N, ans=0;
int f[MAXN];

struct City{
    int x;
    int y;
}pos[MAXN];

bool cmp(City a, City b){
    return a.x < b.x;
}

int main(){
    scanf("%d", &N);

    for (int i=1; i<=N; i++){
        scanf("%d%d", &pos[i].x, &pos[i].y);
    }

    sort(pos+1, pos+N+1, cmp);

    for (int i=1; i<=N; i++){
        f[i] = 1;
    }

    for (int i=1; i<=N; i++){
        for (int j=1; j<i; j++){
            if (pos[j].y <= pos[i].y){
                f[i] = max(f[i], f[j]+1);
            }
        }
    }

    for (int i=1; i<=N; i++){
        ans = max(ans, f[i]);
    }

    printf("%d", ans);
    return 0;
}

BNDSOJ DP-1-4 贝茜的晨练计划

BNDSOJ DP-1-4 贝茜的晨练计划

首先考虑使用 \(dp[i][j]\) 表示第 \(i\) 分钟疲劳度为 \(j\) 能跑的最远距离,但是注意到贝茜一旦开始休息就必须休息到疲劳度为 \(0\),状态不好转移

由于休息到疲劳度为 \(0\) 的条件很强,考虑特化状态,令 \(dp[i]\) 表示第 \(i\) 分钟且疲劳度为 \(0\) 时能跑的最远距离,显然答案为 \(dp[N]\)

考虑转移,首先可以由上一分钟疲劳度就为 \(0\) 转移得来,相当于上一分钟选择休息,没有多跑任何距离,此时转移方程为 \(dp[i] = dp[i-1]\)

其次,可以在该分钟前时间差大于 \(1\) 的位置转移过来;具体的,由于复杂度从 \(0\) 变成 \(0\),一定是跑了一段时间又持续休息了一段时间,而这两段时间显然相等;为方便枚举,不妨设当前时间为 \(i\),这段时间为 \(j\ (j<=min(i/2, M))\),由于贝茜在第 \(i-2 \times j+1\) 到第 \(i-j\) 分钟选择了跑步,因此转移方程为 \(dp[i] = dp[i-2 \times j]+ \sum_{k=i-2 \times j+1}^{i-j} D[k]\),显然可以用前缀和维护

时间复杂度 \(O(NM)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e4+5;

int N, M;
int f[MAXN], D[MAXN], sum[MAXN];

int main(){
    scanf("%d%d", &N, &M);

    for (int i=1; i<=N; i++){
        scanf("%d", &D[i]);
        sum[i] = sum[i-1]+D[i];
    }

    for (int i=1; i<=N; i++){
        f[i] = max(f[i], f[i-1]);

        for (int j=1; j<=min(i/2, M); j++){
            f[i] = max(f[i], f[i-2*j]+sum[i-j]-sum[i-2*j]);
        }
    }

    printf("%d", f[N]);
    return 0;
}

BNDSOJ DP-1-5 ZBRKA

BNDSOJ DP-1-5 ZBRKA

对于一个长度为 \(n-1\) 的 \(1\) 到 \(n-1\) 的排列,设其逆序对数为 \(C\),注意到我们想要往排列中插入数 \(n\) 形成新的排列,又因为 \(n\) 比原排列中的所有数都大,因此可以新形成 \(0\) 到 \(n-1\) 个逆序对,即对长度为 \(n\) 的逆序对数为 \(C\) 到 \(C+n-1\) 的排列的数量贡献都为 \(1\)

具体的,设 \(dp[i][j]\) 表示长度为 \(i\) 的且逆序对数量为 \(j\) 个的排列个数,转移方程为 \(dp[i][j] = \sum_{k=j-(i-1)}^{j} dp[i-1][k]\),显然可以使用前缀和优化,可以压掉一维,但注意每次在转移之前需要先实时更新前缀和数组,同时赋值 \(dp[0] = sum[0] = 1\),因为逆序对数为 \(0\) 时也有一种方案满足 (即 \(1\ 2\ 3\ ...\ n\))

时间复杂度 \(O(NC)\)

C++
#include<bits/stdc++.h>
using namespace std;
#define int long long
const int MAXC = 1e5+5, MOD = 1e9+7;

int N, C;
int f[MAXC], sum[MAXC];

signed main(){
    scanf("%lld%lld", &N, &C);

    for (int i=2; i<=N; i++){
        f[0] = sum[0] = 1;
        for (int j=1; j<=C; j++){
            sum[j] = (sum[j-1]+f[j])%MOD;
        }
        for (int j=0; j<=C; j++){
            if (j >= i){
                f[j] = (sum[j] - sum[j-i])%MOD;
            }
            else{
                f[j] = sum[j]%MOD;
            }
        }
    }

    if (f[C] < 0){
        printf("%lld", MOD+f[C]);
        return 0;   
    }
    printf("%lld", f[C]);
    return 0;
}

BNDSOJ DP-1-8 潜水员

BNDSOJ DP-1-8 潜水员

注意到选择一个气缸会增加两个变量,及氧和氮的数量,因此这是一个二维费用背包,令 \(dp[k][i][j]\) 表示前 \(k\) 个气缸中氧气为数量 \(i\) 且氮气数量为 \(j\) 时总共的最小重量

由于希望气缸总重最小,给 \(dp\) 数组初始赋极大值,同时注意初始化 \(dp[0][0] = 0\),令氧气数量为 \(a[i]\),氮气数量为 \(b[i]\),气缸重量为 \(v[i]\),则转移方程为 \(dp[k][i][j] = min(dp[k-1][i][j], dp[k-1][i-a[k]][j-b[k]]+v[k])\),第一维可以压掉

注意转移时,不一定氧的数量与氮的数量的上界一定是 \(m\) 和 \(n\),因此设定一个偏移量 \(DIF = 80\),氧和氮的上界分别为 \(m+DIF\) 与 \(n+DIF\)

注意枚举答案时要枚举到所装多于 \(m\) 与 \(n\) 时的状态,取最大值

时间复杂度 \(O(kmn)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXK = 1e4+5, MAXQ = 1005, DIF = 80;

int m, n, ans=2147483647;
int k;
int a[MAXK], b[MAXK], c[MAXK];
int dp[MAXQ][MAXQ];

int main(){
    memset(dp, 0x7f, sizeof(dp));
    dp[0][0] = 0;
    scanf("%d%d", &m, &n);
    scanf("%d", &k);

    for (int i=1; i<=k; i++){
        scanf("%d%d%d", &a[i], &b[i], &c[i]);
    }

    for (int l=1; l<=k; l++){
        for (int i=m+DIF; i>=a[l]; i--){
            for (int j=n+DIF; j>=b[l]; j--){
                dp[i][j] = min(dp[i][j], dp[i-a[l]][j-b[l]]+c[l]);
            }
        }
    }

    for (int i=m; i<=m+DIF; i++){
        for (int j=n; j<=n+DIF; j++){
            ans = min(ans, dp[i][j]);
        }
    }

    printf("%d", ans);
    return 0;
}

BNDSOJ DP-1-10 金明的预算方案

BNDSOJ DP-1-10 金明的预算方案

对于每个主件及其的配件,只有 买主件、买主件和 \(1\) 个附件、买主件和 \(2\) 个附件三种购买方案,且只能选择一种,因此可以视为分组背包

注意价值为 \(v[i] \times w[i]\) 而非 \(v[i]\)

时间复杂度 \(O(NM)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXT = 505, MAXN = 1e5+5;

int N, M, T=0;
int cnt[MAXT], belong[MAXT];
int w[MAXT][MAXT], v[MAXT][MAXT];
int f[MAXN];

int main(){
    scanf("%d%d", &N, &M);

    for (int i=1; i<=M; i++){
        int price, value, type;
        scanf("%d%d%d", &price, &value, &type);
        if (type == 0){
            T++;
            cnt[T]++;
            belong[i] = T;
            w[T][cnt[T]] = price;
            v[T][cnt[T]] = price*value;
        }
        else{
            cnt[belong[type]]++;
            w[belong[type]][cnt[belong[type]]] = w[belong[type]][cnt[belong[type]]-1]+price;
            v[belong[type]][cnt[belong[type]]] = v[belong[type]][cnt[belong[type]]-1]+price*value;
        }   
    }

    /*
    for (int i=1; i<=T; i++){
        cout << "object " << i << endl;
        cout << "main weight: " << w[i][1] << " value: " << v[i][1] << endl;
        cout << "side1 weight: " << w[i][2] << " value: " << v[i][2] << endl;
        cout << "side2 weight: " << w[i][3] << " value: " << v[i][3] << endl;
    }
    */

    for (int k=1; k<=T; k++){
        for (int i=N; i>=0; i--){
            for (int j=1; j<=cnt[k]; j++){
                if (i >= w[k][j]){
                    f[i] = max(f[i], f[i-w[k][j]]+v[k][j]);
                }
            }
        }
    }

    printf("%d", f[N]);
    return 0;
}

BNDSOJ DP-2-2 橱窗布置

BNDSOJ DP-2-2 橱窗布置

定义状态 \(dp[i][j]\) 表示前 \(i\) 朵花中,第 \(i\) 朵花放在第 \(j\) 个花瓶时美学值的最大值

考虑转移,注意到我们已经固定了 \(i\) 的位置,因此不难想到进一步固定 \(i-1\) 的位置,进行转移;由于第 \(i-1\) 朵花至少放在第 \(i-1\) 个花瓶中,至多放在第 \(j-1\) 个花瓶中,因此转移方程为 \(dp[i][j] = \sum_{k=i-1}^{j-1} max(dp[i-1][k]+beauty[i][j])\) (\(beauty[i][j]\) 表示第 \(i\) 朵花在第 \(j\) 个花瓶中的美学值)

由于还需要记录方案,考虑用 \(from[i][j]\) 保存一个 \(pair<int, int>\),表示其由哪个状态转移过来,递归输出即可

时间复杂度 \(O(FV^2)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXF = 505, MAXV = 505;

int F, V, ans=-2147483647, final=-1;
int beauty[MAXF][MAXV];
int dp[MAXF][MAXV];
pair <int, int> from[MAXF][MAXV];

void getans(int step, int pos){
    if (step == 1){
        printf("%d ", pos);
        return;
    }
    // cout << "debug: " << pos << " " << from[pos].second << endl;
    getans(from[step][pos].first, from[step][pos].second); 
    printf("%d ", pos);
}

int main(){
    scanf("%d%d", &F, &V);
    memset(dp, -0x3f, sizeof(dp));
    dp[0][0] = 0;

    for (int i=1; i<=F; i++){
        for (int j=1; j<=V; j++){
            scanf("%d", &beauty[i][j]);
        }
    }

    for (int i=1; i<=F; i++){
        for (int j=i; j<=V-(F-i); j++){
            for (int k=i-1; k<=j-1; k++){
                if (dp[i-1][k]+beauty[i][j] > dp[i][j]){
                    dp[i][j] = dp[i-1][k]+beauty[i][j]; 
                    from[i][j] = {i-1, k};
                }
            }
        }
    }

    for (int i=F; i<=V; i++){
        if (dp[F][i] > ans){
            ans = max(ans, dp[F][i]);
            final = i;
        }
    }
    printf("%d\n", ans);
    getans(F, final);
}

BNDSOJ DP-2-3 花匠

BNDSOJ DP-2-3 花匠

题目要求的实际上是一个交替增减的子序列,由于 \(O(n^2)\) 的时间复杂度会超时,因此考虑只从序列中的上一位转移状态,因此发现实际上只需要考虑序列变化的趋势,即如果趋势变化则贡献 \(+1\),若不变化则贡献也不变

因此设 \(dp[i][0/1]\) 表示在原序列第 \(i\) 位变化趋势为 \(0/1\) (\(0\) 表示当前变化趋势为上升,\(1\) 表示当前变化趋势为下降) 的留下的花的最大值;设 \(a_i\) 为原序列的第 \(i\) 项,分情况讨论,当 \(a_i > a_{i-1}\) 时,\(dp[i][0] = max(dp[i-1][0], dp[i-1][1]+1)\) 且 \(dp[i][1] = dp[i-1][1]\),当 \(a_i < a_{i-1}\) 时,\(dp[i][1] = max(dp[i-1][1], dp[i-1][0]+1)\) 且 \(dp[i][0] = dp[i-1][0]\),当 \(a_i = a_{i-1}\) 时,\(dp[i][0] = dp[i-1][0]\) 且 \(dp[i][1] = dp[i-1][1]\)

边界条件显然为 \(dp[1][0] = dp[1][1] = 1\),输出时直接输出 \(max(dp[n][0], dp[n][1])\) 即可,\(n\) 为原序列长度,本质上实际是递推

时间复杂度 \(O(n)\)

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 1e5+5;

int n, ans=0;
int num[MAXN];
int dp[MAXN][2];

int main(){
    scanf("%d", &n);

    for(int i=1; i<=n; i++){
        scanf("%d", &num[i]);
    }

    dp[1][0] = dp[1][1] = 1;

    for (int i=2; i<=n; i++){
        if (num[i] > num[i-1]){
            dp[i][0] = max(dp[i-1][0], dp[i-1][1]+1);
            dp[i][1] = dp[i-1][1];
        }
        else if (num[i] < num[i-1]){
            dp[i][1] = max(dp[i-1][1], dp[i-1][0]+1);
            dp[i][0] = dp[i-1][0];
        }
        else{
            dp[i][0] = dp[i-1][0];
            dp[i][1] = dp[i-1][1];
        }
    }

    printf("%d", max(dp[n][0], dp[n][1]));
    return 0;
}

BNDSOJ DP-2-4 编辑距离

设 \(dp[i][j]\) 为将 \(A\) 串前 \(i\) 位变为 \(B\) 串前 \(j\) 位所需的最小代价,考虑由 \(i-1\) 与 \(j-1\) 转移而来,由于支持修改、添加和删除,实际上有如下几种方式

  1. 将 \(A\) 串前 \(i-1\) 个变为 \(B\) 串前 \(j-1\) 个,再将 \(A_i\) 修改为 \(B_j\) 即可,分两种情况,如果 \(A_i = B_j\) 则 \(dp[i][j] = dp[i-1][j-1]+1\),否则 \(dp[i][j] = dp[i-1][j-1]+1\)
  2. 将 \(A\) 串前 \(i-1\) 个变为 \(B\) 串前 \(j\) 个,再将 \(A_i\) 删除即可,\(dp[i][j] = dp[i-1][j]+1\)
  3. 将 \(A\) 串前 \(i\) 个变为 \(B\) 串前 \(j-1\) 个,再在 \(A\) 中插入 \(B_j\) 即可,\(dp[i][j] = dp[i][j-1]+1\)

设 \(A\) 的长度为 \(n\),\(B\) 的长度为 \(m\),则初始情况为 \(dp[0][i] = i(1<=i<=m)\),即将空串变为 \(B\) 的前 \(i\) 个字符,需要插入 \(i\) 次;\(dp[i][0] = i(1<=i<=n)\),即将 \(A\) 的前 \(i\) 个字符变为空串,需要删除 \(i\) 次;最终答案即为 \(dp[n][m]\)

时间复杂度 \(O(nm)\),\(n\) 与 \(m\) 为串长

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 5005;
string a, b;

int dp[MAXN][MAXN];

int main(){
    cin >> a >> b;

    for (int i=0; i<a.size(); i++){
        dp[i+1][0] = i+1;
    }
    for (int i=0; i<b.size(); i++){
        dp[0][i+1] = i+1;
    }

    for (int i=0; i<a.size(); i++){
        for (int j=0; j<b.size(); j++){
            if (a[i] == b[j]){
                dp[i+1][j+1] = min(dp[i][j], min(dp[i][j+1]+1, dp[i+1][j]+1));
            }
            else{
                dp[i+1][j+1] = min(dp[i][j]+1, min(dp[i][j+1]+1, dp[i+1][j]+1));    
            }
        }
    }

    cout << dp[a.size()][b.size()];
    return 0;
}

BNDSOJ DP-2-5 乌龟棋

BNDSOJ DP-2-5 乌龟棋

首先考虑设 \(dp[i][a][b][c][d]\) 表示走到第 \(i\) 个格子用了 \(a\) 张 \(1\) 卡片,\(b\) 张 \(2\) 卡片,\(c\) 张 \(3\) 卡片,\(d\) 张 \(4\) 卡片,但是这样 \(dp\) 会超时;我们注意到一个很关键的点,只需要各用了几张不同类型的卡片,实际上就已经可以算出当前到的格子位置,因此第一维实际上是没有用的

设 \(dp[a][b][c][d]\) 为 (走到当前格子) 四种卡分别用了多少张时能获得价值的最大值,显然当前格子位置为 \(chart = a \times 1 + b \times 2 + c \times 3 + d \times 4\),因为可以通过在距离当前格子前 \(1/2/3/4\) 个位置的格子使用 一个 \(a/b/c/d\) 类型的卡片从而前进到当前格子,因此转移方程即为 \(dp[a][b][c][d] = max(dp[a-1][b][c][d], dp[a][b-1][c][d], dp[a][b][c-1][d], dp[a][b][c][d-1])+val[chart]\),其中 \(val[i]\) 为在第 \(i\) 个格子可以获得的价值;注意 \(a/b/c/d = 0\) 时不能再由 \(a-1/b-1/c-1/d-1\) 转移,需要特殊考虑

初始情况为 \(dp[0][0][0][0] = val[1]\),因为题目中说了自动获得起点位置的价值

时间复杂度 \(O(A \times B \times C \times D)\),\(A/B/C/D\) 为四种卡片的个数

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXN = 405;

int N, M;
int num[MAXN], cnt[5];
int dp[45][45][45][45];

int main(){ 
    scanf("%d%d", &N, &M);

    for (int i=1; i<=N; i++){
        scanf("%d", &num[i]);   
    }
    for (int i=1; i<=M; i++){
        int val;
        scanf("%d", &val);
        cnt[val]++;
    }

    dp[0][0][0][0] = num[1];

    for (int i=0; i<=cnt[1]; i++){
        for (int j=0; j<=cnt[2]; j++){
            for (int k=0; k<=cnt[3]; k++){
                for (int l=0; l<=cnt[4]; l++){
                    int chart = i*1+j*2+k*3+l*4+1;
                    if (i!=0){
                        dp[i][j][k][l] = max(dp[i][j][k][l], dp[i-1][j][k][l]+num[chart]);
                    }
                    if (j!=0){
                        dp[i][j][k][l] = max(dp[i][j][k][l], dp[i][j-1][k][l]+num[chart]);
                    }
                    if (k!=0){
                        dp[i][j][k][l] = max(dp[i][j][k][l], dp[i][j][k-1][l]+num[chart]);
                    }
                    if (l!=0){
                        dp[i][j][k][l] = max(dp[i][j][k][l], dp[i][j][k][l-1]+num[chart]);
                    }
                }
            }
        }
    }

    printf("%d", dp[cnt[1]][cnt[2]][cnt[3]][cnt[4]]);
    return 0;
}

BNDSOJ DP-2-6 传纸条

BNDSOJ DP-2-6 传纸条

由于有两路传纸条路径不能相交的限制,直接跑两次最大值 \(dp\) 不能保证正确性;

考虑设 \(dp[i_1][j_1][i_2][j_2]\) 为第一路纸条传到 \((i_1, j_1)\) 且第二路纸条传到 \((i_2, j_2)\) 时的最大值;关键在于使得两条路线不会相交,观察到两条路线必然一条在 "右上",一条在 "左下",钦定 \((i_1, j_1)\) 所在路线在 "右上",因此枚举 \(i_1(1<=i_1<=n)\), \(j_1(1<=j_1<=m)\),\(i_2(i_1<i_2<=n)\),\(j_2(1<=j_2<j_1)\),这样保证 \((i_2, j_2)\) 所在线路与 \((i_1, j_1)\) 线路总不相交,转移时直接由上下左右移动一个位置转移即可,具体的,\(dp[i_1][j_1][i_2][j_2] = max(dp[i_1-1][j_1][i_2-1][j_2], dp[i_1][j_1-1][i_2-1][j_2], dp[i_1-1][j_1][i_2][j_2-1], dp[i_1][j_1-1][i_2][j_2-1])+val[i_1][j_1]+val[i_2][j_2]\),其中 \(val[i][j]\) 表示在 \((i, j)\) 位置的同学的好心程度

不需要另设边界条件,因为没有开始传时最大价值就是 \(0\);注意最终答案为 \(dp[n-1][m][n][m-1]\),因为显然 "右上" 线的终点为 \((n-1, m)\) 即右下角上方,"左上" 线的终点为 \((n, m-1)\) 即右下角左方

时间复杂度 \(O(N^2M^2)\)

代码中的 \(n\) 与 \(m\) 和思路中是反过来的

C++
#include<bits/stdc++.h>
using namespace std;
const int MAXM = 55, MAXN = 55;

int m, n;
int mp[MAXM][MAXN];
int f[MAXM][MAXN][MAXM][MAXN];

int main(){
    scanf("%d%d", &m, &n);

    for (int i=1; i<=m; i++){
        for (int j=1; j<=n; j++){
            scanf("%d", &mp[i][j]);
        }
    }

    for (int i=1; i<=m; i++){
        for (int j=1; j<=n; j++){
            for (int k=i+1; k<=m; k++){
                for (int l=1; l<j; l++){
                    f[i][j][k][l] = max(
                        max(f[i][j-1][k][l-1], f[i][j-1][k-1][l]), 
                        max(f[i-1][j][k][l-1], f[i-1][j][k-1][l])
                    );
                    f[i][j][k][l] += (mp[i][j]+mp[k][l]);
                }
            }
        }
    }

    printf("%d", f[m-1][n][m][n-1]);
    return 0;
}